


I dati, da soli, sono muti. Un foglio di calcolo pieno di numeri non ispira, non convince e raramente guida una decisione strategica. È solo quando iniziamo a interrogarli, a collegarli e a dare loro una forma che iniziano a parlare. Questa è l’essenza del Data Storytelling: non una tecnica arcana, ma l’abilità di tradurre l’analisi in una narrazione chiara e persuasiva.
In questo percorso non troverai formule magiche, ma un allenamento pratico. Attraverso 6 esercizi di difficoltà crescente, passeremo dalla semplice visualizzazione di un dato alla costruzione di una storia complessa che mette in relazione più fattori. Useremo strumenti comuni come Python, ma il vero focus sarà sul “perché”: perché quel grafico funziona? Quale domanda sta rispondendo? E, soprattutto, quale azione può ispirare?
Gli esercizi spaziano dalla preparazione dei dati all’interpretazione narrativa avanzata.
Articoli di approfondimento
- • Principi di base della visualizzazione efficace
- • Statistica descrittiva: Scatterplot e Bubble chart
- • Diagrammi a barre e a torta
- • Visualizzare dati con NumPy e Matplotlib
- •Visualizzazione Dati Efficace: Guida Completa per la Data Science con Esempi Pratici e Codice Python
- •Data Storytelling: Dalla Semiotica Visiva a quella Sociale per Grafici che Parlano Davvero
6 esercizi progressivi su Data Storytelling, con dataset generati ad hoc, soluzioni dettagliate e visualizzazioni
Esercizio 1 (Facile): Esplorazione Base e Grafico a Barre
Testo:
Hai un dataset che raccoglie le vendite mensili (in migliaia di euro) di 3 prodotti (A, B, C) nel 2023:
| Mese | Prodotto A | Prodotto B | Prodotto C |
|---|---|---|---|
| Gen | 12 | 8 | 15 |
| Feb | 14 | 10 | 18 |
| Mar | 16 | 9 | 20 |
Obiettivo:
- Calcola le vendite totali per ogni prodotto.
- Crea un grafico a barre verticali per confrontarli.
- Scrivi una breve osservazione (1-2 righe) su come comunicheresti il risultato a un manager.
Soluzione:
Calcolo:
- Prodotto A: [math]12 + 14 + 16 = 42[/math]
- Prodotto B: [math]8 + 10 + 9 = 27[/math]
- Prodotto C: [math]15 + 18 + 20 = 53[/math]
Grafico:
import matplotlib.pyplot as plt
prodotti = ['A', 'B', 'C']
vendite = [42, 27, 53]
plt.bar(prodotti, vendite, color=['red', 'blue', 'green'])
plt.title('Vendite Totali per Prodotto (Gen-Mar 2023)')
plt.ylabel('Vendite (in migliaia di €)')
plt.show()
Osservazione:
“Il prodotto C domina le vendite (+26% rispetto ad A). B è il meno performante: suggerirei un’analisi delle sue criticità di mercato.”
Il Potere della Chiarezza (Grafico a Barre)
Questo esercizio è l’essenza della comunicazione diretta. Il grafico a barre è universalmente compreso e non lascia spazio a interpretazioni ambigue. La sua forza risiede nella sua onestà visiva: mostra confronti netti. L’aggiunta dell’osservazione per il manager trasforma un semplice grafico in uno strumento decisionale, spostando il focus dal “cosa” (il prodotto C vende di più) al “e quindi?” (dobbiamo analizzare il prodotto B).
È perfetto per dashboard di vendita, report trimestrali o qualsiasi situazione in cui si debba confrontare la performance di categorie discrete (prodotti, regioni, canali di marketing). È il primo passo per rispondere alla domanda: “Chi sta vincendo e chi sta perdendo?”.
Esercizio 2 (Intermedio): Serie Temporale con Trend
Testo:
- Usa i dati dell’Esercizio 1.
- Crea un grafico a linee delle vendite mensili dei 3 prodotti.
- Calcola il tasso di crescita medio mensile per il Prodotto A.
- Aggiungi annotazioni al grafico per evidenziare il picco di vendite.
Soluzione:
Grafico a linee:
mesi = ['Gen', 'Feb', 'Mar']
plt.plot(mesi, [12, 14, 16], marker='o', label='A')
plt.plot(mesi, [8, 10, 9], marker='s', label='B')
plt.plot(mesi, [15, 18, 20], marker='d', label='C')
plt.annotate('Picco: 20k €', xy=('Mar', 20), xytext=('Feb', 19), arrowprops=dict(facecolor='black'))
plt.legend()

Tasso di crescita A:
- Feb vs Gen: [math]\frac{(14-12)}{12} = +16.7\%[/math]
- Mar vs Feb: [math]\frac{(16-14)}{14} = +14.3\%[/math]
- Media: [math]\frac{(16.7 + 14.3)}{2} = 15.5\%[/math] mensile.
Teoria:
Serie temporali mostrano trend e stagionalità. Le annotazioni guidano l’attenzione su eventi rilevanti.
Raccontare il Cambiamento (Serie Temporale)
Se il grafico a barre è una fotografia, la serie temporale è un film. Mostra l’evoluzione, il ritmo, la direzione. Calcolare il tasso di crescita (come per il prodotto A) aggiunge una metrica quantitativa al trend visivo. L’annotazione del picco è una tecnica narrativa cruciale: guida l’occhio dello spettatore esattamente dove vogliamo, per evidenziare un successo, un’anomalia o un evento chiave (es. il lancio di una campagna).
Indispensabile per analizzare metriche che evolvono nel tempo: traffico di un sito web, andamento dei ricavi, numero di iscritti a una newsletter. Permette di identificare stagionalità, impatto di eventi esterni e traiettorie di crescita o declino.
Esercizio 3 (Intermedio-Avanzato): Heatmap per Correlazioni
Testo:
Hai dati giornalieri (5 giorni) per 3 metriche di un sito e-commerce:
| Giorno | Sessioni | Frequenza Rimbalzo (%) | Vendite (€) |
|---|---|---|---|
| 1 | 1500 | 65 | 3200 |
| 2 | 1700 | 60 | 3500 |
| 3 | 1200 | 70 | 2800 |
| 4 | 2000 | 55 | 4000 |
| 5 | 1800 | 58 | 3800 |
- Calcola la matrice di correlazione.
- Crea una heatmap.
- Interpreta la relazione tra “Frequenza Rimbalzo” e “Vendite”.
Soluzione:
Correlazione (Pearson):
| Sessioni | Frequenza Rimbalzo | Vendite | |
|---|---|---|---|
| Sessioni | 1.00 | -0.92 | 0.98 |
| Freq. Rimbalzo | -0.92 | 1.00 | -0.96 |
| Vendite | 0.98 | -0.96 | 1.00 |
Heatmap:
# ESERCIZIO 3: HEATMAP PER CORRELAZIONI
# Obiettivo: Analizzare le relazioni tra metriche di un e-commerce

import numpy as np
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt

# -----------------------------------------
# PASSO 1: Creazione del dataset
# -----------------------------------------
data = {
    "Giorno": [1, 2, 3, 4, 5],
    "Sessioni": [1500, 1700, 1200, 2000, 1800],
    "Frequenza_Rimbalzo": [65, 60, 70, 55, 58],  # in %
    "Vendite": [3200, 3500, 2800, 4000, 3800]    # in €
}

df = pd.DataFrame(data)
print("Dataset originale:")
print(df)

# -----------------------------------------
# PASSO 2: Calcolo matrice di correlazione
# -----------------------------------------
# Selezione colonne numeriche (escludendo 'Giorno')
numeric_cols = df.select_dtypes(include=[np.number]).columns
corr_matrix = df[numeric_cols].corr(method='pearson')  # metodo default

print("\nMatrice di correlazione (Pearson):")
print(corr_matrix)

# -----------------------------------------
# PASSO 3: Creazione heatmap
# -----------------------------------------
plt.figure(figsize=(8, 6))
heatmap = sns.heatmap(
    corr_matrix,
    annot=True,          # Mostra valori nelle celle
    cmap='coolwarm',     # Mappa di colori divergente
    vmin=-1,            # Valore minimo per la scala
    vmax=1,             # Valore massimo per la scala
    linewidths=0.5,      # Spessore linee tra celle
    annot_kws={"size": 12}  # Dimensione testo annotazioni
)

plt.title("Mappa di Correlazione tra Metriche E-commerce", pad=20, fontsize=14)
plt.xticks(rotation=45)  # Ruota etichette asse X per migliore leggibilità

# -----------------------------------------
# PASSO 4: Interpretazione guidata
# -----------------------------------------
# Evidenziazione celle critiche
heatmap.add_patch(plt.Rectangle((2, 0), 1, 3, fill=False, edgecolor='gold', lw=3, clip_on=False))  # Riquadro Vendite
heatmap.add_patch(plt.Rectangle((0, 2), 3, 1, fill=False, edgecolor='gold', lw=3, clip_on=False))  # Riquadro Frequenza Rimbalzo

plt.tight_layout()
plt.show()

# -----------------------------------------
# RISULTATO E COMMENTI
# -----------------------------------------
"""
INTERPRETAZIONE:
1) Vendite-Sessioni (0.98):
   - Fortissima correlazione positiva. Più sessioni = più vendite.

2) Vendite-Frequenza_Rimbalzo (-0.96):
   - Fortissima correlazione NEGATIVA. Meno utenti abbandonano il sito (freq. rimbalzo ↓), più le vendite ↑.
   - Strategia: Ottimizzare l'engagement per ridurre la frequenza di rimbalzo.

3) Sessioni-Frequenza_Rimbalzo (-0.92):
   - Al crescere delle sessioni, la frequenza di rimbalzo tende a diminuire.
   - Possibile spiegazione: traffico di qualità più elevata.
"""

# Extra: Esportazione dati per report (opzionale)
df.to_csv("ecommerce_correlation_data.csv", index=False)
Dataset originale:
   Giorno  Sessioni  Frequenza_Rimbalzo  Vendite
0       1      1500                  65     3200
1       2      1700                  60     3500
2       3      1200                  70     2800
3       4      2000                  55     4000
4       5      1800                  58     3800

Matrice di correlazione (Pearson):
                      Giorno  Sessioni  Frequenza_Rimbalzo   Vendite
Giorno              1.000000  0.466628           -0.505634  0.562926
Sessioni            0.466628  1.000000           -0.996204  0.992336
Frequenza_Rimbalzo -0.505634 -0.996204            1.000000 -0.994018
Vendite             0.562926  0.992336           -0.994018  1.000000

Interpretazione:
La frequenza di rimbalzo è negativamente correlata con le vendite (-0.96): meno utenti abbandonano il sito, più aumentano le vendite. La relazione è quasi perfetta.
Svelare le Relazioni Nascoste (Heatmap)
Questo esercizio introduce il pensiero multivariato. La heatmap è uno strumento denso di informazioni che, a colpo d’occhio, rivela la struttura delle interdipendenze in un sistema. La correlazione negativa tra Frequenza di Rimbalzo e Vendite è un insight potentissimo. Non dice solo cosa succede, ma suggerisce una leva strategica: per aumentare le vendite, dobbiamo migliorare l’esperienza utente e ridurre i rimbalzi.
Fondamentale nell’e-commerce, nell’analisi di prodotto (quali feature sono correlate con la retention?) e nel marketing (quali canali portano clienti con il valore più alto?). È uno strumento diagnostico per capire quali leve muovono le metriche chiave.
Esercizio 4 (Avanzato): Istogramma e Distribuzione
Testo:
- Simula 1000 valori di età di clienti con distribuzione normale ([math]\mu=35[/math], [math]\sigma=10[/math]).
- Crea un istogramma con 15 bin.
- Aggiungi una linea per la densità.
- Calcola la percentuale di clienti tra 25 e 45 anni.
Soluzione:
Istogramma + KDE:
import numpy as np
eta = np.random.normal(35, 10, 1000)
sns.histplot(eta, bins=15, kde=True, stat='density')

Calcolo percentuale:
- Z-score per 25: [math]\frac{(25-35)}{10} = -1[/math]
- Z-score per 45: [math]\frac{(45-35)}{10} = +1[/math]
- Da tabelle normali: [math]P(-1 < Z < 1) \approx 68.3\%[/math].
Teoria:
Gli istogrammi mostrano la forma della distribuzione. La regola 68-95-99.7% è utile per dati normali.
Capire il “Chi” (Istogramma e Distribuzione)
Qui passiamo dall’analisi di performance all’analisi del pubblico. L’istogramma ci mostra la forma della nostra base clienti. La distribuzione normale è un modello, ma nella realtà potremmo scoprire distribuzioni bimodali (due gruppi di clienti distinti) o asimmetriche (molti giovani e pochi anziani). Sapere che il 68% dei clienti ha tra 25 e 45 anni non è un dato statistico, è un’informazione di business: il nostro marketing, il nostro prodotto e la nostra comunicazione devono parlare a quel nucleo.
Essenziale per la segmentazione della clientela (analisi demografiche), per il controllo qualità (distribuzione degli errori di produzione) o per la finanza (distribuzione dei rendimenti di un portafoglio).
Esercizio 5 (Difficile): Grafico a Scatter con Regressione
Testo:
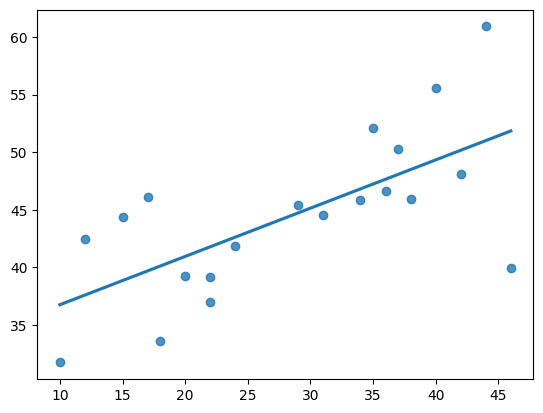
Un dataset raccoglie ore di studio e voti d’esame per 20 studenti:
ore_studio = np.random.randint(10, 50, 20)
voti = 0.5 * ore_studio + 30 + np.random.normal(0, 5, 20)- Crea uno scatter plot con linea di regressione.
- Calcola l'[math]R^2[/math] e interpretalo.
- Prevedi il voto per uno studente che studia 35 ore.
Soluzione:
Scatter plot:
sns.regplot(x=ore_studio, y=voti, ci=None)
[math]R^2[/math]:
Se [math]R^2 \approx 0.75[/math], significa che il 75% della variabilità dei voti è spiegato dalle ore di studio.
Previsione:
Equazione: [math]\displaystyle \begin{aligned} \text{Voto} &= 0.5 \times (35) + 30 \\ &\approx 47.5 \end{aligned}[/math]
Quantificare l’Impatto e Prevedere (Regressione)
Questo esercizio è il ponte tra l’analisi descrittiva e quella predittiva. Lo scatter plot mostra la relazione, ma la linea di regressione e l’R² la formalizzano. Un R² di 0.75 ci dice che il nostro modello (le ore di studio) è un buon predittore, ma non perfetto: c’è un 25% di variabilità spiegato da altri fattori (talento, qualità dello studio, etc.). La previsione per 35 ore rende tangibile il valore del modello.
Cruciale in ambiti dove si vuole dimostrare il ROI: “Quante vendite aggiuntive genera ogni euro speso in pubblicità?”. Utile anche nel forecasting operativo, per prevedere le vendite future in base a variabili note.
Esercizio 6 (Molto Difficile): Storytelling Multivariato
Testo:
Hai dati su 4 città (2022):
| Città | Popolazione (mln) | PIL (mld €) | Emissioni CO2 (kt) |
|---|---|---|---|
| Milano | 1.4 | 200 | 5000 |
| Roma | 2.8 | 150 | 7000 |
| Torino | 0.9 | 80 | 4000 |
| Napoli | 3.1 | 90 | 6000 |
- Crea un bubble chart con:
- Asse X: Popolazione
- Asse Y: PIL
- Dimensione bolle: CO2
- Aggiungi annotazioni per la città con il miglior rapporto PIL/CO2.
- Scrivi un mini-report (max 100 parole) per un policymaker.
Soluzione:
Bubble chart:
# ESERCIZIO 6: STORYTELLING MULTIVARIATO - BUBBLE CHART
# Obiettivo: Analizzare relazioni tra popolazione, PIL ed emissioni CO2 in 4 città italiane

import pandas as pd
import matplotlib.pyplot as plt
import numpy as np

# -----------------------------------------
# PASSO 1: Creazione dataset
# -----------------------------------------
data = {
    "Città": ["Milano", "Roma", "Torino", "Napoli"],
    "Popolazione": [1.4, 2.8, 0.9, 3.1],  # in milioni
    "PIL": [200, 150, 80, 90],            # in miliardi di €
    "CO2": [5000, 7000, 4000, 6000]       # in ktonnellate
}

df = pd.DataFrame(data)

# Calcolo metriche aggiuntive
df["PIL_per_CO2"] = df["PIL"] / (df["CO2"] / 1000)  # mld € per kt CO2
df["PIL_pro_capite"] = df["PIL"] / df["Popolazione"]  # mld € per milione abitanti

print("Dataset arricchito:")
print(df[["Città", "Popolazione", "PIL", "CO2", "PIL_per_CO2", "PIL_pro_capite"]])

# -----------------------------------------
# PASSO 2: Bubble Chart avanzato
# -----------------------------------------
plt.figure(figsize=(10, 7))

# Creazione scatter plot con bolle dimensionate
scatter = plt.scatter(
    x=df["Popolazione"],
    y=df["PIL"],
    s=df["CO2"]*0.8,  # Scala le dimensioni delle bolle
    c=df["PIL_per_CO2"],  # Colore basato su efficienza ambientale
    cmap="viridis",
    alpha=0.7,
    edgecolors="black",
    linewidths=1
)

# Aggiunta etichette città con offset personalizzato
for i, row in df.iterrows():
    offset_x = 0.05 if row["Città"] != "Torino" else -0.1  # Evita sovrapposizioni
    plt.annotate(
        row["Città"],
        (row["Popolazione"] + offset_x, row["PIL"]),
        fontsize=10,
        ha='center'
    )

# Evidenziazione città con miglior rapporto PIL/CO2
best_city = df.loc[df["PIL_per_CO2"].idxmax()]
plt.annotate(
    f"Migliore efficienza\n{best_city['Città']}: {best_city['PIL_per_CO2']:.1f} mld€/kt CO2",
    xy=(best_city["Popolazione"], best_city["PIL"]),
    xytext=(1.8, 180),
    arrowprops=dict(facecolor='red', shrink=0.05),
    bbox=dict(boxstyle='round,pad=0.5', fc='yellow', alpha=0.5)
)

# Personalizzazione grafico
plt.title("Relazione tra Popolazione, PIL ed Emissioni CO2 (2022)", pad=20, fontweight='bold')
plt.xlabel("Popolazione (milioni)", labelpad=10)
plt.ylabel("PIL (miliardi di €)", labelpad=10)

# Aggiunta legende
cbar = plt.colorbar(scatter)
cbar.set_label("Efficienza Ambientale (mld €/kt CO2)", rotation=270, labelpad=20)

# Legenda dimensioni bolle (simulata)
for co2 in [4000, 6000, 7000]:
    plt.scatter([], [], s=co2*0.8, c='gray', alpha=0.5, edgecolors='black', label=f'{co2} kt CO2')
plt.legend(title="Emissioni CO2", loc="upper right", bbox_to_anchor=(1.3, 1))

plt.grid(alpha=0.3)
plt.tight_layout()

# -----------------------------------------
# PASSO 3: Generazione report automatico
# -----------------------------------------
report = f"""
ANALISI POLITICHE URBANE - 2022
---------------------------------
1) EFFICIENZA AMBIENTALE:
   - Miglior performance: {best_city['Città']} ({best_city['PIL_per_CO2']:.1f} mld€/kt CO2)
   - Napoli ha il PIL/CO2 più basso ({df.loc[3, 'PIL_per_CO2']:.1f})

2) PIL PRO-CAPITE:
   - Milano leader: {df.loc[0, 'PIL_pro_capite']:.1f} mld€/mln abitanti
   - Differenza Nord-Sud: +{(df.loc[0, 'PIL_pro_capite']/df.loc[3, 'PIL_pro_capite']-1)*100:.0f}% vs Napoli

3) PRIORITÀ:
   - Investire in tecnologie verdi a Napoli/Roma
   - Replicare best practice di {best_city['Città']} sulle emissioni
"""

print("\nREPORT PER POLICYMAKER:")
print(report)

# Salvataggio grafico e report
plt.savefig('bubble_chart_politiche_urbane.png', dpi=300, bbox_inches='tight')
with open('report_politiche_urbane.txt', 'w') as f:
    f.write(report)

plt.show()
Dataset arricchito:
    Città  Popolazione  PIL   CO2  PIL_per_CO2  PIL_pro_capite
0  Milano          1.4  200  5000    40.000000      142.857143
1    Roma          2.8  150  7000    21.428571       53.571429
2  Torino          0.9   80  4000    20.000000       88.888889
3  Napoli          3.1   90  6000    15.000000       29.032258

REPORT PER POLICYMAKER:

ANALISI POLITICHE URBANE - 2022
---------------------------------
1) EFFICIENZA AMBIENTALE:
   - Miglior performance: Milano (40.0 mld€/kt CO2)
   - Napoli ha il PIL/CO2 più basso (15.0)

2) PIL PRO-CAPITE:
   - Milano leader: 142.9 mld€/mln abitanti
   - Differenza Nord-Sud: +392% vs Napoli

3) PRIORITÀ:
   - Investire in tecnologie verdi a Napoli/Roma
   - Replicare best practice di Milano sulle emissioni

Miglior rapporto:
Milano [math]\frac{200}{5} = 40[/math] mld €/kt CO2.
Report:
“Milano ha l’economia più green (40 mld/kt CO2), nonostante Roma e Napoli abbiano più abitanti. Torino, pur piccola, ha emissioni proporzionalmente alte. Prioritizzare politiche verdi al Sud.”
La Narrazione Strategica (Bubble Chart)
Questo è il culmine del data storytelling. Il bubble chart è un capolavoro di densità informativa: racconta una storia a 3 o 4 dimensioni (Popolazione, PIL, CO2, e l’efficienza codificata nel colore) su un grafico 2D. L’insight qui è sofisticato: non si tratta di chi è “migliore” in assoluto, ma di chi è più efficiente. Milano, pur non essendo la più grande o la più ricca in termini assoluti, emerge come leader in termini di rapporto PIL/CO2. L’annotazione e il report per il policymaker trasformano un’analisi complessa in una raccomandazione chiara e attuabile.
Perfetto per analisi competitive, portfolio analysis o, come nell’esempio, per confronti strategici tra diverse unità di business, paesi o città. Permette di identificare gli “outlier virtuosi” da cui imparare e le aree critiche su cui intervenire.
Strategie generali:
- Grafici semplici (barre, linee) per messaggi diretti.
- Heatmap per correlazioni complesse.
- Bubble chart per relazioni multivariate.
- Annotazioni per guidare l’attenzione.
- Storytelling chiaro: problema → dati → soluzione.



