Un modello predittivo può avere buone metriche e continuare a essere difficile da utilizzare.
Immaginiamo il team Customer Success di CloudDesk davanti a circa 1.500 clienti. Il modello segnala che alcuni stanno mostrando comportamenti compatibili con un futuro deterioramento dell’utilizzo della piattaforma. Fin qui tutto bene.
Il problema arriva subito dopo.
Il Customer Success Manager vuole sapere quali segnali hanno portato a quella previsione, quali clienti meritano un intervento prioritario e, soprattutto, se quei segnali possono essere collegati a un’azione concreta.
Se la risposta è una lista di quaranta variabili, coefficienti che cambiano sensibilmente da un campione all’altro e indicatori difficili da tradurre in una procedura operativa, la qualità predittiva da sola non risolve il problema.
In azienda un modello deve fare qualcosa di più che prevedere. Deve poter essere controllato, interpretato, alimentato con dati disponibili e trasformato in una decisione.
È questo il motivo per cui la regressione Lasso è interessante in un contesto come CloudDesk. La penalizzazione L1 tende a ridurre i coefficienti e, quando la penalizzazione è sufficientemente forte, può portarli esattamente a zero. Il risultato può essere un modello più compatto e più semplice da comunicare.
Ma c’è una precisazione fondamentale.
Una variabile con coefficiente zero non è necessariamente una variabile inutile. Significa che, date le altre feature presenti nel modello e il valore di penalizzazione scelto, il suo contributo aggiuntivo non è risultato sufficiente per mantenerla nella soluzione penalizzata.
Questa distinzione diventa particolarmente importante quando più variabili contengono informazioni simili.
L’obiettivo dell’esercizio, quindi, non è semplicemente ottenere il maggior numero possibile di coefficienti uguali a zero. Vogliamo capire come Lasso controlla la complessità, come cambia il compromesso tra errore e semplicità, quanto sia stabile la selezione delle feature e come analizzare i residui per capire dove il modello non rappresenta adeguatamente il fenomeno.
La domanda finale non sarà soltanto:
quanto bene prevede il modello?
Sarà anche:
quanto è solido, leggibile e utilizzabile il modello quando deve entrare in un processo decisionale reale?
Il caso CloudDesk
CloudDesk è un SaaS B2B con circa 1.500 clienti attivi.
Il team Customer Success vuole individuare i segnali che anticipano un deterioramento dell’utilizzo della piattaforma, così da poter intervenire prima che il cliente riduca il proprio coinvolgimento o abbandoni il servizio.
Abbiamo a disposizione alcune variabili comportamentali, economiche e operative:
| Feature | Significato |
|---|---|
logins |
numero di accessi alla piattaforma |
ticket_aperti |
ticket di assistenza aperti |
nps |
Net Promoter Score |
mrr |
ricavo mensile ricorrente |
giorni_da_ultimo_accesso |
giorni trascorsi dall’ultimo accesso |
moduli_attivi |
numero di moduli utilizzati |
onboarding_completato |
indicatore di completamento dell’onboarding |
ticket_risolti_24h |
indicatore di tempestività nella risoluzione dei ticket |
Il target è un indice continuo di deterioramento.
Nel dataset simulato il valore più elevato rappresenta un maggiore deterioramento.
Questa impostazione è utile perché permette di affrontare il problema come una regressione, mantenendo però una lettura aziendale molto concreta:
la previsione non è fine a se stessa, ma dovrebbe aiutare il team a decidere dove concentrare le proprie attività.
Perché usare Lasso?
La regressione lineare classica cerca coefficienti che minimizzano l’errore quadratico.
Lasso aggiunge una penalizzazione basata sul valore assoluto dei coefficienti:
[math]\displaystyle \begin{aligned}
\min_{\beta}
\left[
\frac{1}{2n}\sum_{i=1}^{n}(y_i-\hat y_i)^2
+
\alpha\sum_j|\beta_j|
\right]
\end{aligned}[/math]
Il primo termine misura l’errore di previsione.
Il secondo penalizza la complessità del modello.
Il parametro alpha controlla la forza della penalizzazione.
Quando alpha è piccolo, il modello è relativamente vicino a una regressione non penalizzata.
Aumentando alpha, la penalizzazione diventa più forte e i coefficienti vengono progressivamente contratti.
In alcuni casi la contrazione porta un coefficiente esattamente a zero. La feature corrispondente non contribuisce quindi più alla previsione del modello penalizzato.
Questo è il meccanismo che rende Lasso particolarmente interessante per la selezione delle feature. LassoCV permette inoltre di scegliere il valore di alpha attraverso cross-validation, anziché fissarlo arbitrariamente.
Perché standardizzare le feature?
Nel nostro caso utilizziamo:
StandardScaler()prima di Lasso.
La scelta è importante perché le variabili hanno scale molto diverse.
nps può assumere valori compresi indicativamente tra 0 e 100, mrr può essere nell’ordine delle centinaia o delle migliaia, mentre onboarding_completato è una variabile binaria.
Senza standardizzazione, la penalizzazione non opererebbe in modo confrontabile sui coefficienti associati a variabili misurate su scale differenti.
Nel nostro modello, quindi, la pipeline è:
StandardScaler → LassoCVI coefficienti ottenuti dal Lasso sono coefficienti riferiti alle feature standardizzate. Non vanno quindi interpretati come “variazione del deterioramento per una unità originale della variabile”.
Il loro segno e la loro grandezza relativa sono comunque molto utili per comprendere quali variabili contribuiscono alla previsione e in quale direzione.
Dataset simulato
import numpy as np
import pandas as pd

from sklearn.model_selection import train_test_split
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LassoCV
from sklearn.metrics import mean_absolute_error, r2_score

# ============================================================
# Dataset CloudDesk
# ============================================================

rng = np.random.default_rng(42)

n = 1500

logins = rng.poisson(12, n)
ticket_aperti = rng.poisson(3, n)
nps = rng.normal(45, 18, n).clip(0, 100)

mrr = rng.lognormal(
    mean=6.5,
    sigma=0.5,
    size=n
)

giorni_da_ultimo_accesso = rng.gamma(
    2.5,
    3,
    n
)

moduli_attivi = rng.poisson(
    4,
    n
).clip(0, 10)

onboarding_completato = rng.binomial(
    1,
    0.8,
    n
)

ticket_risolti_24h = rng.binomial(
    1,
    0.7,
    n
)

# ============================================================
# Target continuo
# ============================================================

deterioramento = (
    2.0
    - 0.05 * logins
    + 0.20 * ticket_aperti
    - 0.025 * nps
    + 0.15 * giorni_da_ultimo_accesso
    - 0.20 * moduli_attivi
    - 0.50 * onboarding_completato
    - 0.15 * ticket_risolti_24h
    + rng.normal(0, 0.7, n)
)

df_cloud = pd.DataFrame({
    "logins": logins,
    "ticket_aperti": ticket_aperti,
    "nps": nps,
    "mrr": mrr,
    "giorni_da_ultimo_accesso": giorni_da_ultimo_accesso,
    "moduli_attivi": moduli_attivi,
    "onboarding_completato": onboarding_completato,
    "ticket_risolti_24h": ticket_risolti_24h,
    "deterioramento": deterioramento
})

# ============================================================
# X e y
# ============================================================

X = df_cloud.drop(
    columns="deterioramento"
)

y = df_cloud["deterioramento"]

# ============================================================
# Split
# ============================================================

X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42
)

# ============================================================
# Lasso con alpha scelto tramite cross-validation
# ============================================================

pipe = Pipeline([
    ("scaler", StandardScaler()),
    (
        "lasso",
        LassoCV(
            alphas=np.logspace(-4, 1, 100),
            cv=5,
            max_iter=100_000
        )
    )
])

pipe.fit(
    X_train,
    y_train
)

# ============================================================
# Predizione
# ============================================================

y_pred = pipe.predict(X_test)

mae = mean_absolute_error(
    y_test,
    y_pred
)

r2 = r2_score(
    y_test,
    y_pred
)

print(f"MAE: {mae:.3f}")
print(f"R²:  {r2:.3f}")

# ============================================================
# Coefficienti
# ============================================================

lasso = pipe.named_steps["lasso"]

coefs = pd.Series(
    lasso.coef_,
    index=X.columns
)

print("\nCoefficienti Lasso:")
print(
    coefs.sort_values()
)

# ============================================================
# Feature selezionate
# ============================================================

selected = coefs[
    coefs != 0
]

print("\nFeature mantenute:")
print(selected)

# ============================================================
# Feature eliminate
# ============================================================

eliminated = coefs[
    coefs == 0
].index.tolist()

print("\nFeature con coefficiente zero:")
print(eliminated)

print(
    f"\nAlpha selezionato: "
    f"{lasso.alpha_:.6f}"
)
Output atteso
Con il dataset e il random_state indicati nell’esercizio possiamo ottenere un risultato come:
MAE: 0.608
R²:  0.620

Coefficienti Lasso:
nps                        -0.473097
moduli_attivi              -0.398430
onboarding_completato      -0.195966
logins                     -0.167070
ticket_risolti_24h         -0.065213
mrr                         0.014896
ticket_aperti               0.386200
giorni_da_ultimo_accesso    0.749936
dtype: float64

Feature mantenute:
logins                     -0.167070
ticket_aperti               0.386200
nps                        -0.473097
mrr                         0.014896
giorni_da_ultimo_accesso    0.749936
moduli_attivi              -0.398430
onboarding_completato      -0.195966
ticket_risolti_24h         -0.065213
dtype: float64

Feature con coefficiente zero:
[]

Alpha selezionato: 0.003275
Il primo elemento interessante è che nessuna feature viene eliminata.
A prima vista potrebbe sembrare un risultato deludente, soprattutto se abbiamo introdotto Lasso proprio per ottenere un modello più compatto.
In realtà non lo è.
LassoCV non ha come obiettivo “eliminare più variabili possibile”. Cerca un valore di alpha che offra un buon compromesso rispetto alla performance valutata attraverso la cross-validation.
Nel nostro caso il valore selezionato è:
alpha = 0.003275La penalizzazione è quindi sufficiente a contrarre i coefficienti, ma non abbastanza forte da portarli a zero.
Questa distinzione è fondamentale.
Lasso non promette automaticamente un modello sparso.
La sparsità è una possibile conseguenza della penalizzazione, non il fine assoluto della procedura.
Come leggere MAE e R²
Il risultato:
MAE: 0.608
R²:  0.620
deve essere interpretato sulla scala del nostro target.
Il MAE, Mean Absolute Error, è circa 0,61. Significa che, nel campione di test, la distanza assoluta media tra valore osservato e valore previsto è di circa 0,61 unità dell’indice di deterioramento.
Non possiamo però stabilire se 0,61 sia “buono” o “cattivo” senza conoscere la scala del problema e il costo degli errori.
Se il target varia tipicamente tra 0 e 10, 0,61 potrebbe essere gestibile.
Se invece un errore di 0,6 punti produce sistematicamente decisioni commerciali sbagliate, la stessa metrica potrebbe essere insufficiente.
L’R² pari a 0,62 indica che il modello spiega circa il 62% della variabilità del target nel campione di test rispetto al riferimento costituito dalla previsione della media.
Anche in questo caso non bisogna trasformare il numero in una valutazione assoluta.
Un R² elevato non garantisce automaticamente un modello utile al business e un R² moderato non implica necessariamente che il modello non abbia valore operativo.
Per CloudDesk potrebbe essere più importante che il modello riesca a identificare correttamente i clienti che stanno entrando nella fascia di maggiore deterioramento rispetto alla capacità di spiegare perfettamente ogni variazione dell’indice.
Questa è una distinzione importante tra accuratezza statistica e utilità decisionale.
I coefficienti raccontano una storia, ma non tutta la storia
Il coefficiente maggiore in valore assoluto è associato a:
giorni_da_ultimo_accesso 0.749936Il segno positivo è coerente con il processo generativo del dataset: all’aumentare dei giorni dall’ultimo accesso, aumenta il deterioramento previsto.
Anche ticket_aperti presenta un coefficiente positivo:
0.386200mentre nps e moduli_attivi presentano coefficienti negativi.
Nel dataset simulato questo è coerente con la logica con cui abbiamo costruito il target.
Un numero maggiore di accessi, un NPS più elevato e un maggiore utilizzo dei moduli sono associati a un minore deterioramento.
Ma bisogna fare attenzione a un dettaglio.
I coefficienti appartengono a un modello in cui le feature sono state standardizzate.
Non possiamo quindi dire, per esempio:
“un giorno in più di inattività aumenta il deterioramento di 0,75 punti.”
Questa interpretazione sarebbe sbagliata.
Possiamo invece affermare che, nel modello standardizzato, giorni_da_ultimo_accesso presenta un’associazione positiva relativamente forte con il target rispetto alle altre feature.
Questo tipo di lettura è molto più appropriato.
Perché mrr non viene eliminato?
Il caso di mrr è particolarmente interessante.
Nel dataset simulato mrr non viene utilizzato direttamente nella costruzione del target:
deterioramento = (
    ...
)
Nonostante questo, il modello gli assegna:
mrr = 0.014896Il coefficiente è molto piccolo rispetto a quelli delle altre variabili, ma non è esattamente zero.
Questo è un ottimo esempio didattico perché mostra che un coefficiente diverso da zero non equivale a una prova che la variabile rappresenti un segnale sostanziale del fenomeno.
Il modello lavora su un campione finito e rumoroso. Una variabile che non ha un ruolo diretto nel processo generativo può comunque mostrare una relazione casuale con il target nel campione osservato.
Per un progetto reale questo significa che non dovremmo presentare automaticamente una feature selezionata come “driver del fenomeno”.
Lasso risponde a una domanda più circoscritta:
quale configurazione di coefficienti offre un compromesso conveniente tra adattamento ai dati e penalizzazione?
Non risponde, da solo, alla domanda causale:
questa variabile determina il deterioramento?
Sono problemi diversi.
Quando Lasso non elimina nessuna feature
Il risultato:
Feature con coefficiente zero:
[]
è quindi perfettamente valido.
Non significa che Lasso abbia fallito.
Significa che il valore di alpha scelto dalla cross-validation non produce una soluzione sufficientemente penalizzata da azzerare alcuni coefficienti.
Se il management chiedesse:
“Vogliamo esattamente quattro variabili.”
non sarebbe corretto aumentare arbitrariamente alpha fino a ottenere quattro coefficienti non nulli e poi presentare quel modello come “il modello migliore”.
In quel caso avremmo introdotto un requisito organizzativo, non una conclusione statistica.
La domanda diventerebbe:
quanto siamo disposti a sacrificare in termini di performance e stabilità per ottenere un modello più semplice?
Questa domanda può avere una risposta ragionevole, ma deve essere affrontata esplicitamente.
Alpha: il compromesso tra errore e semplicità
Possiamo visualizzare cosa accade al variare di alpha.
Per rendere il concetto evidente utilizziamo un dataset sintetico in cui conosciamo anche quali coefficienti sono stati utilizzati per generare il target.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import Lasso

# ============================================================
# Dataset sintetico
# ============================================================

rng = np.random.default_rng(42)

n = 1000
p = 10

X = rng.normal(
    0,
    1,
    (n, p)
)

true_beta = np.array([
    2.5,
    -1.8,
    0.0,
    0.0,
    1.2,
    0.0,
    0.0,
    0.8,
    0.0,
    0.0
])

y = (
    X @ true_beta
    + rng.normal(0, 1, n)
)

# ============================================================
# Split train/test
# ============================================================

split = 800

X_train = X[:split]
X_test = X[split:]

y_train = y[:split]
y_test = y[split:]

# ============================================================
# Valutazione di diversi alpha
# ============================================================

alphas = np.logspace(
    -3,
    1,
    30
)

results = []

for alpha in alphas:

    model = Pipeline([
        (
            "scaler",
            StandardScaler()
        ),
        (
            "lasso",
            Lasso(
                alpha=alpha,
                max_iter=100_000
            )
        )
    ])

    model.fit(
        X_train,
        y_train
    )

    pred = model.predict(
        X_test
    )

    mae = np.mean(
        np.abs(
            y_test - pred
        )
    )

    n_features = np.sum(
        model.named_steps[
            "lasso"
        ].coef_ != 0
    )

    results.append({
        "alpha": alpha,
        "MAE": mae,
        "feature_nonzero": n_features
    })

results = pd.DataFrame(
    results
)

print(
    results.head(10)
)

# ============================================================
# MAE in funzione di alpha
# ============================================================

plt.figure(
    figsize=(9, 5)
)

plt.semilogx(
    results["alpha"],
    results["MAE"],
    marker="o"
)

plt.xlabel("Alpha")
plt.ylabel("MAE sul test")

plt.title(
    "Trade-off tra regolarizzazione ed errore"
)

plt.grid(
    True,
    alpha=0.3
)

plt.show()

# ============================================================
# Numero di feature non nulle
# ============================================================

plt.figure(
    figsize=(9, 5)
)

plt.semilogx(
    results["alpha"],
    results["feature_nonzero"],
    marker="o"
)

plt.xlabel("Alpha")

plt.ylabel(
    "Numero di coefficienti non nulli"
)

plt.title(
    "Sparsità del modello al variare di alpha"
)

plt.grid(
    True,
    alpha=0.3
)

plt.show()
L’output iniziale può essere simile a:
      alpha       MAE  feature_nonzero
0  0.001000  0.835694               10
1  0.001374  0.835752               10
2  0.001887  0.835830               10
3  0.002593  0.835939               10
4  0.003562  0.836087               10
5  0.004894  0.836291               10
6  0.006723  0.836617               10
7  0.009237  0.837096               10
8  0.012690  0.837910               10
9  0.017433  0.839479               10
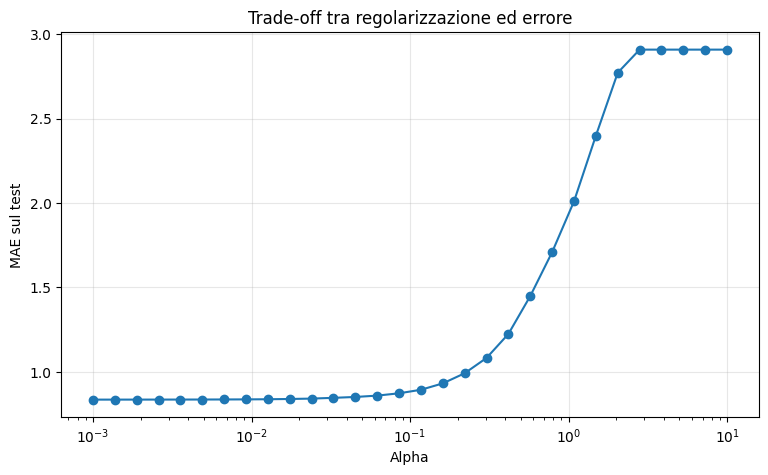
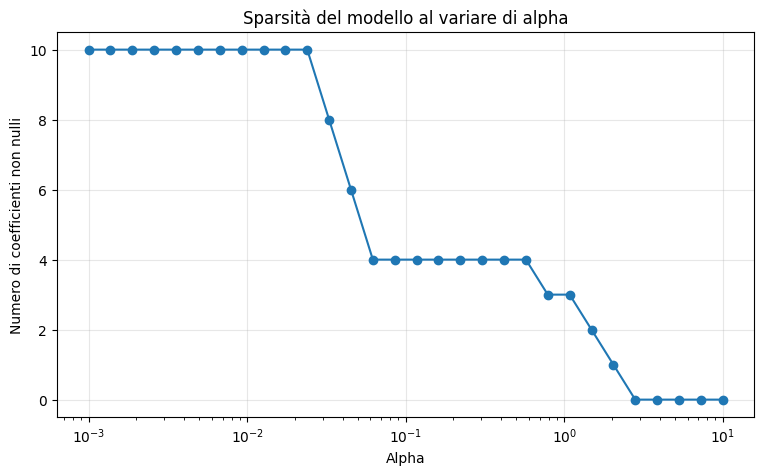
Nella prima parte del percorso osserviamo una situazione interessante: aumentando leggermente alpha, l’errore cresce molto poco e il numero di feature rimane invariato.
Questo significa che, in quella zona, la penalizzazione sta modificando i coefficienti senza produrre ancora una vera riduzione della dimensionalità.
Procedendo verso valori più elevati di alpha, alcuni coefficienti possono diventare esattamente zero.
A quel punto il modello diventa più semplice, ma il costo della semplificazione può manifestarsi attraverso un aumento dell’errore.
Non dobbiamo però cercare automaticamente il punto con il minor numero di feature.
Il valore interessante è quello in cui il compromesso tra performance, complessità e stabilità è ragionevole rispetto al problema aziendale.
Inoltre, questo secondo esercizio utilizza un singolo split train/test. Il grafico è quindi utile per comprendere il comportamento della regolarizzazione, ma non dovrebbe essere considerato una stima definitiva del trade-off. Per una scelta formale di alpha è preferibile utilizzare cross-validation.
La trappola del “voglio quattro variabili”
Quando un modello deve essere utilizzato da un team operativo, la richiesta di semplificarlo è comprensibile.
Ogni feature comporta costi di acquisizione, controllo della qualità, manutenzione e integrazione.
Il problema nasce quando il numero di feature viene trasformato nell’obiettivo principale.
Supponiamo che il management decida:
“Il modello deve utilizzare al massimo quattro variabili.”
Il vincolo può essere legittimo.
Ma la risposta non dovrebbe essere:
aumentiamo alpha fino a quando rimangono quattro coefficienti.Questo procedimento confonderebbe due problemi diversi.
Il primo è statistico:
quale penalizzazione offre una buona capacità di generalizzazione?
Il secondo è organizzativo:
quanta complessità siamo disposti a sostenere per ottenere un modello più semplice?
I due problemi devono essere messi in relazione, non confusi.
Una possibile procedura consiste nel costruire una curva che mostri contemporaneamente:
- errore di validazione;
- numero di feature;
- stabilità delle feature;
- costo operativo delle informazioni.
In questo modo la scelta di un modello più compatto diventa una decisione esplicita e documentata.
Una feature selezionata è stabile?
C’è un’altra domanda importante che spesso manca quando si interpreta Lasso.
Supponiamo che nps venga selezionato nel nostro campione.
Quanto possiamo essere sicuri che venga selezionato anche se cambiamo leggermente il campione?
La risposta non è necessariamente “molto”.
Quando due feature contengono informazione simile, Lasso può scegliere una delle due oppure modificare la distribuzione dei coefficienti in funzione del campione e della penalizzazione.
Per questo motivo, in un progetto reale può essere utile ripetere la procedura su diversi campioni e misurare la frequenza con cui ciascuna feature viene selezionata.
Una misura semplice è:
[math]\displaystyle \begin{aligned}
SF_j =
\frac{\text{numero di selezioni della feature }j}
{\text{numero totale delle ripetizioni}}
\end{aligned}[/math]
Una possibile interpretazione potrebbe essere:
| Feature | Frequenza di selezione |
|---|---|
giorni_da_ultimo_accesso |
98% |
nps |
96% |
moduli_attivi |
91% |
ticket_aperti |
84% |
logins |
61% |
ticket_risolti_24h |
43% |
mrr |
18% |
Questi valori sono soltanto un esempio del tipo di output che potremmo ottenere.
Il punto non è stabilire una soglia universale oltre la quale una feature diventa “importante”.
La frequenza di selezione serve a introdurre una seconda dimensione nella valutazione: quanto la scelta del modello dipende dal particolare campione osservato?
Una feature selezionata nel 98% delle ripetizioni presenta una stabilità diversa da una selezionata nel 18%.
Per il Customer Success questa distinzione può essere molto più utile di una semplice lista di coefficienti.
Il grafico Residui vs Predetti
Anche dopo aver costruito un modello con performance soddisfacenti, il lavoro non è terminato.
Il MAE ci dice quanto il modello sbaglia mediamente.
Non ci dice come sono distribuiti gli errori.
Definiamo il residuo come:
[math]e_i = y_i-\hat y_i[/math]
Se il residuo è positivo, il modello ha sottostimato il valore osservato.
Se è negativo, lo ha sovrastimato.
Il primo strumento diagnostico consiste nel rappresentare i residui rispetto ai valori predetti.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

from sklearn.model_selection import train_test_split
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LassoCV

# ============================================================
# Dataset CloudDesk
# ============================================================

rng = np.random.default_rng(42)

n = 1000

X = pd.DataFrame({
    "logins": rng.poisson(12, n),
    "ticket_aperti": rng.poisson(3, n),
    "nps": rng.normal(45, 18, n).clip(0, 100),
    "giorni_da_ultimo_accesso": rng.gamma(
        2.5,
        3,
        n
    ),
    "moduli_attivi": rng.poisson(
        4,
        n
    ).clip(0, 10)
})

y = (
    2
    - 0.05 * X["logins"]
    + 0.20 * X["ticket_aperti"]
    - 0.025 * X["nps"]
    + 0.15 * X["giorni_da_ultimo_accesso"]
    - 0.20 * X["moduli_attivi"]
    + rng.normal(0, 0.7, n)
)

# ============================================================
# Split
# ============================================================

X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42
)

# ============================================================
# Modello
# ============================================================

pipe = Pipeline([
    (
        "scaler",
        StandardScaler()
    ),
    (
        "lasso",
        LassoCV(
            cv=5,
            max_iter=100_000
        )
    )
])

pipe.fit(
    X_train,
    y_train
)

# ============================================================
# Predizioni e residui
# ============================================================

y_pred = pipe.predict(
    X_test
)

residui = (
    y_test - y_pred
)

# ============================================================
# Grafico
# ============================================================

plt.figure(
    figsize=(9, 5)
)

plt.scatter(
    y_pred,
    residui,
    alpha=0.6
)

plt.axhline(
    0,
    linestyle="--"
)

plt.xlabel(
    "Valori predetti"
)

plt.ylabel(
    "Residui"
)

plt.title(
    "Residui vs valori predetti"
)

plt.tight_layout()

plt.show()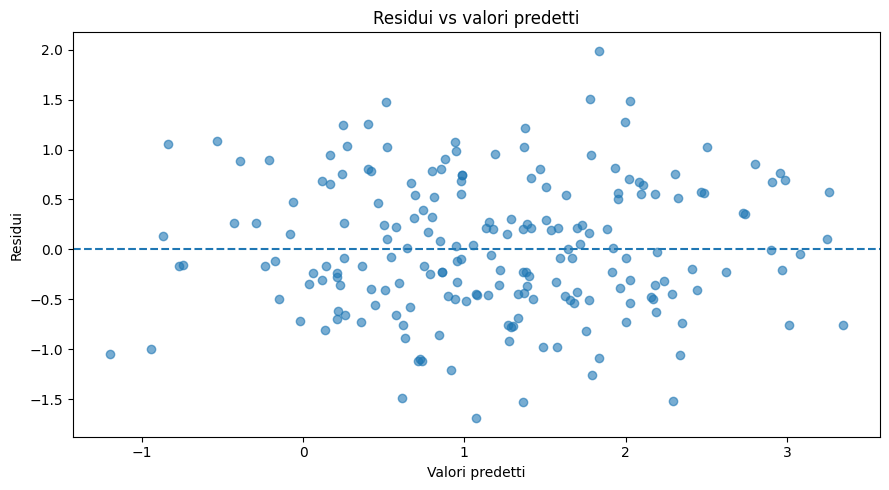
Il riferimento principale è la linea:
[math]e=0[/math]
Non ci aspettiamo che tutti i punti siano vicini alla linea.
Ci interessa invece capire se esiste una struttura.
Una distribuzione relativamente casuale dei residui intorno allo zero è compatibile con un modello che sta catturando adeguatamente la struttura media del fenomeno.
Al contrario, una curvatura, un andamento a imbuto o gruppi distinti possono suggerire che qualcosa nella rappresentazione del problema meriti un approfondimento.
Quando compare una curvatura
Supponiamo di osservare residui prevalentemente negativi per valori predetti bassi, positivi nella zona centrale e nuovamente negativi per valori predetti elevati.
Una struttura di questo tipo è compatibile con una relazione non lineare non adeguatamente rappresentata dal modello.
Il problema non è necessariamente Lasso.
Lasso penalizza i coefficienti, ma non trasforma automaticamente una relazione lineare in una relazione non lineare.
Se il vero fenomeno contiene soglie, saturazioni o curvature, possiamo dover introdurre:
- trasformazioni delle variabili;
- termini polinomiali;
- spline;
- interazioni;
- oppure un modello non lineare.
Nel caso CloudDesk, per esempio, l’effetto dei giorni dall’ultimo accesso potrebbe non essere costante.
Passare da 2 a 5 giorni di inattività potrebbe avere un impatto diverso rispetto al passaggio da 30 a 33 giorni.
Il residuo ci segnala quindi che vale la pena verificare la forma della relazione.
Non ci dice automaticamente quale trasformazione utilizzare.
Quando compare una forma a imbuto
Un’altra configurazione frequente è quella in cui la dispersione dei residui aumenta al crescere dei valori predetti.
Visivamente il grafico può assumere una forma simile a un imbuto.
Questa configurazione è compatibile con l’eteroschedasticità, cioè con una variabilità dell’errore che non rimane costante lungo il range delle previsioni.
La conseguenza pratica è importante.
Il modello potrebbe continuare a produrre previsioni utili, ma l’incertezza associata alle previsioni può cambiare in modo significativo tra clienti con livelli diversi di deterioramento.
La situazione diventa particolarmente importante quando il modello viene utilizzato per inferenza statistica.
Se l’obiettivo è principalmente predittivo, invece, possiamo essere più interessati alla performance fuori campione e alla qualità della calibrazione dell’incertezza.
La stessa anomalia diagnostica può quindi avere conseguenze diverse a seconda dell’uso che intendiamo fare del modello.
Quando compaiono dei cluster
Un gruppo di residui prevalentemente positivi e un altro prevalentemente negativi può suggerire che il modello stia trattando come un’unica popolazione clienti con dinamiche differenti.
Nel caso CloudDesk, potrebbe esserci una differenza tra:
- clienti con pochi moduli attivi;
- clienti che utilizzano intensivamente la piattaforma;
- clienti enterprise;
- clienti ancora nella fase di onboarding.
Non dobbiamo però concludere automaticamente che esistano segmenti distinti.
Possiamo utilizzare il pattern come indicazione per effettuare un’analisi successiva.
Per esempio, possiamo colorare il grafico per segmento cliente e verificare se la struttura dei residui corrisponde effettivamente a una variabile aziendale.
In questo senso la diagnostica può diventare anche uno strumento per individuare fenomeni che il modello attuale non sta rappresentando.
Il residuo medio vicino a zero non basta
Con un modello di regressione dotato di intercetta, la somma dei residui sul campione utilizzato per la stima è vincolata a essere zero.
Questo però non significa che gli errori siano casuali.
Residui positivi e negativi possono compensarsi perfettamente pur seguendo una struttura molto evidente.
Per questo motivo:
residui.mean()non è una diagnostica sufficiente.
Una media vicina a zero non esclude:
- non linearità;
- eteroschedasticità;
- cluster;
- outlier;
- segmenti con errori sistematici.
Il punto non è soltanto sapere se gli errori si compensano.
Dobbiamo capire come sono distribuiti e se presentano una struttura.
Q-Q plot: come sono distribuiti i residui?
Il Q-Q plot confronta i quantili osservati dei residui con quelli attesi sotto una distribuzione di riferimento, normalmente la distribuzione normale.
Se i punti seguono approssimativamente la retta di riferimento, la distribuzione dei residui è compatibile, almeno visivamente, con la normalità.
Se invece le code si allontanano sistematicamente dalla retta, possiamo avere una distribuzione con code più pesanti o una forma diversa da quella normale.
Questo strumento deve essere interpretato con attenzione.
La normalità dei residui non è un requisito generale per ottenere buone previsioni con Lasso.
Diventa più importante quando il modello viene utilizzato per specifiche procedure inferenziali.
Il Q-Q plot, inoltre, non ci dice se la relazione tra variabili sia correttamente specificata e non identifica da solo le osservazioni influenti.
È quindi un tassello della diagnostica, non un certificato di qualità del modello.
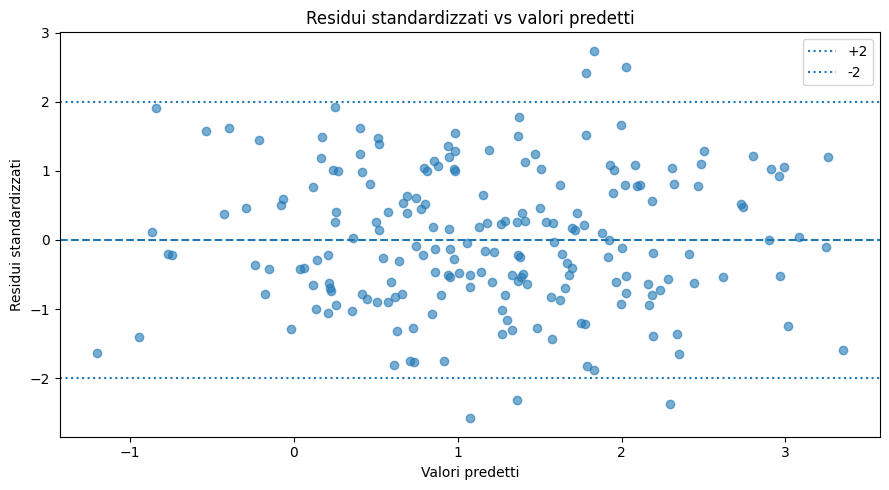
Residui standardizzati: quali osservazioni presentano errori particolarmente grandi?
Un residuo deve essere interpretato anche rispetto alla variabilità complessiva degli errori.
Un errore di una unità può essere molto grande in un modello estremamente preciso e relativamente normale in un modello molto rumoroso.
I residui standardizzati riportano gli errori su una scala comune.
Come riferimento diagnostico possiamo utilizzare, con cautela, valori intorno a +2 e -2.
Un’osservazione oltre queste soglie merita attenzione.
Non significa però che debba essere eliminata.
Potrebbe rappresentare:
- un errore nei dati;
- un cliente particolarmente anomalo;
- un comportamento raro ma reale;
- una combinazione di caratteristiche non rappresentata dal modello.
La domanda corretta non è:
“Come elimino questo punto?”
ma:
“Perché questo punto si comporta in modo così diverso dagli altri?”
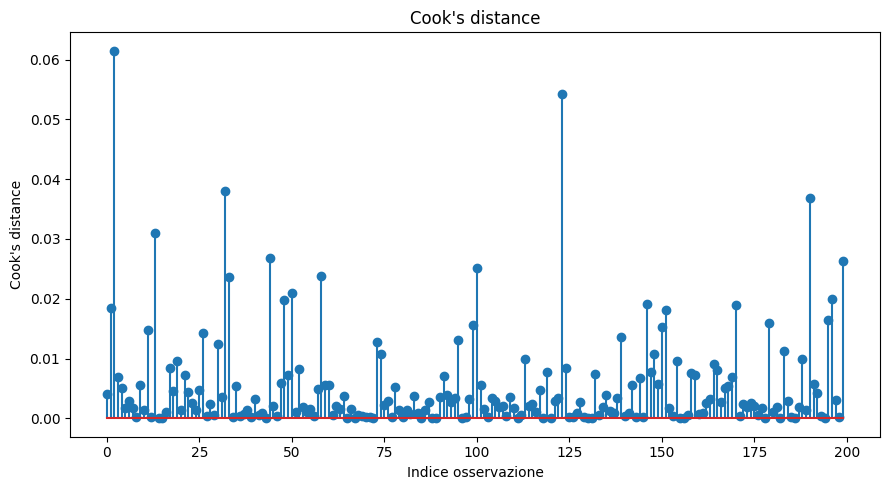
Cook’s distance: quali osservazioni possono influenzare la stima?
La Cook’s distance risponde a una domanda diversa.
Non misura semplicemente quanto il modello sbaglia.
Misura quanto la stima di un modello OLS può essere influenzata dalla presenza di una determinata osservazione. Le funzioni di influenza di statsmodels sono infatti costruite per risultati ottenuti con OLS.
Questo introduce una precisazione importante per il nostro esercizio.
Il modello principale è Lasso.
statsmodels non sta calcolando la Cook’s distance del Lasso.
Se utilizziamo un OLS ausiliario per ottenere la Cook’s distance, dobbiamo dichiararlo esplicitamente.
Possiamo quindi utilizzare OLS come strumento diagnostico complementare, non come se fosse una misura diretta dell’influenza delle osservazioni sul modello Lasso.
Il codice può essere organizzato così:
import statsmodels.api as sm
import numpy as np
import matplotlib.pyplot as plt

# ============================================================
# Q-Q plot dei residui del Lasso
# ============================================================

sm.qqplot(
    residui,
    line="45",
    fit=True
)

plt.title(
    "Q-Q plot dei residui del Lasso"
)

plt.tight_layout()
plt.show()


# ============================================================
# Residui standardizzati descrittivi
# ============================================================

residui_standardizzati = (
    residui
    / residui.std(ddof=1)
)

plt.figure(
    figsize=(9, 5)
)

plt.scatter(
    y_pred,
    residui_standardizzati,
    alpha=0.6
)

plt.axhline(
    0,
    linestyle="--"
)

plt.axhline(
    2,
    linestyle=":"
)

plt.axhline(
    -2,
    linestyle=":"
)

plt.xlabel(
    "Valori predetti dal Lasso"
)

plt.ylabel(
    "Residui standardizzati"
)

plt.title(
    "Residui standardizzati vs predetti"
)

plt.tight_layout()
plt.show()


# ============================================================
# OLS ausiliario
# ============================================================
#
# Questo modello NON sostituisce il Lasso.
# Viene utilizzato esclusivamente per ottenere
# misure classiche di influenza OLS.
# ============================================================

X_train_ols = sm.add_constant(
    X_train
)

ols_model = sm.OLS(
    y_train,
    X_train_ols
).fit()

influenza = (
    ols_model.get_influence()
)

cooks_distance = (
    influenza.cooks_distance[0]
)

# ============================================================
# Cook's distance
# ============================================================

plt.figure(
    figsize=(9, 5)
)

plt.stem(
    np.arange(
        len(cooks_distance)
    ),
    cooks_distance
)

plt.xlabel(
    "Indice osservazione"
)

plt.ylabel(
    "Cook's distance"
)

plt.title(
    "Cook's distance - modello OLS ausiliario"
)

plt.tight_layout()
plt.show()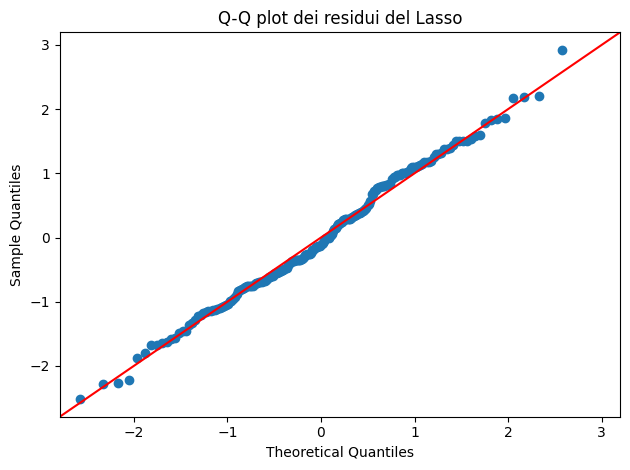
Questa impostazione è metodologicamente più trasparente.
Il Q-Q plot e i residui standardizzati sono riferiti ai residui del Lasso sul test set.
La Cook’s distance, invece, è esplicitamente riferita a un modello OLS ausiliario stimato sul training set.
La separazione è importante perché non dobbiamo confondere la diagnostica della previsione con la diagnostica dell’influenza sui coefficienti.
Come interpretare l’output diagnostico
Il Q-Q plot può mostrare punti abbastanza vicini alla retta centrale, con deviazioni più evidenti nelle code.
Un risultato del genere sarebbe compatibile con una distribuzione dei residui abbastanza vicina alla normalità nella parte centrale, ma con alcune osservazioni estreme.
Non sarebbe corretto concludere automaticamente che il modello sia errato.
Potremmo invece verificare se le osservazioni nelle code corrispondono agli stessi clienti che mostrano residui standardizzati elevati.
Nel grafico dei residui standardizzati, valori intorno a zero indicano errori relativamente contenuti rispetto alla dispersione residua.
Valori oltre circa +2 o -2 costituiscono segnali diagnostici da approfondire, non regole automatiche di eliminazione.
Se, per esempio, osserviamo un cliente con residuo standardizzato pari a 3,5, possiamo controllare:
- qualità dei dati;
- segmento cliente;
- MRR;
- comportamento di utilizzo;
- eventi recenti;
- eventuali caratteristiche non presenti nel dataset.
La Cook’s distance può aggiungere un’informazione diversa.
Un valore elevato indica che, nel modello OLS ausiliario, quell’osservazione merita attenzione perché può avere un’influenza significativa sulla stima.
Non significa che il dato sia sbagliato.
Un cliente enterprise molto grande, per esempio, può essere legittimamente influente perché rappresenta una parte rilevante della popolazione osservata.
Eliminare automaticamente quell’osservazione significherebbe modificare la popolazione a cui il modello si riferisce.
La domanda deve quindi essere:
l’osservazione è errata, rara ma reale, oppure rappresenta un segmento che il modello dovrebbe trattare diversamente?
Outlier e osservazioni influenti non sono la stessa cosa
Questa distinzione è essenziale.
Un outlier nei residui è un’osservazione per la quale il modello commette un errore particolarmente grande.
Un’osservazione influente è invece un’osservazione la cui presenza può modificare sensibilmente la stima del modello.
Le due caratteristiche possono coincidere, ma non necessariamente.
Possiamo avere:
| Situazione | Interpretazione possibile |
|---|---|
| grande residuo, bassa influenza | il modello sbaglia quel caso ma la stima complessiva cambia poco |
| residuo moderato, alta influenza | il punto occupa una posizione particolare nello spazio delle feature |
| grande residuo e alta influenza | osservazione da analizzare con particolare attenzione |
| valore estremo ma dato corretto | caso raro ma reale |
Questa distinzione impedisce uno degli errori più comuni nella diagnostica: eliminare automaticamente tutto ciò che appare anomalo.
Un’anomalia può essere un problema dei dati.
Ma può anche essere informazione.
Dal pattern statistico alla decisione
La diagnostica diventa veramente utile quando ogni pattern osservato viene collegato a una possibile verifica.
| Pattern | Possibile interpretazione | Azione da valutare |
|---|---|---|
| Nuvola casuale | nessuna struttura evidente | proseguire con la validazione |
| Curvatura | relazione non lineare | trasformazioni, spline, interazioni o modello non lineare |
| Forma a imbuto | variabilità dell’errore non costante | analisi dell’eteroschedasticità e dell’incertezza |
| Cluster | segmenti con dinamiche differenti | analisi per segmento o interazioni |
| Residui estremi | casi anomali o fenomeni non rappresentati | controllo dati e analisi dei casi |
| Pattern rispetto a una feature | informazione non catturata | verificare trasformazioni, interazioni o variabili omesse |
| Alta influenza OLS | osservazione capace di modificare la stima OLS | controllare leverage, qualità del dato e rappresentatività |
La tabella non fornisce una procedura automatica.
Indica dove concentrare l’analisi successiva.
Questo è un punto importante perché la diagnostica statistica non sostituisce la conoscenza del processo aziendale.
Dal modello al processo Customer Success
A questo punto possiamo tornare al problema iniziale.
Il modello ha identificato alcune variabili associate al deterioramento.
Ma la parte interessante comincia quando queste variabili vengono collegate a un processo.
Supponiamo che giorni_da_ultimo_accesso risulti una delle feature più stabili.
Il team Customer Success potrebbe definire una procedura in cui un aumento anomalo dell’inattività genera un controllo preventivo.
Se moduli_attivi è fortemente associato al deterioramento, il team potrebbe verificare se i clienti che utilizzano una parte limitata della piattaforma necessitino di attività di formazione o di espansione dell’utilizzo.
Se invece ticket_aperti presenta una relazione positiva con il deterioramento, potrebbe essere utile verificare se determinati problemi di assistenza precedano la riduzione dell’engagement.
Il modello non stabilisce quale intervento debba essere effettuato.
Fornisce un sistema per individuare pattern che possono essere trasformati in ipotesi operative.
La catena decisionale diventa quindi:
segnale
   ↓
previsione
   ↓
priorità
   ↓
verifica del contesto
   ↓
intervento
   ↓
misurazione del risultato
Questo è molto diverso dal semplice utilizzo di una dashboard con un punteggio di rischio.
Perché questo esercizio è interessante dal punto di vista applicativo
L’aspetto più interessante dell’esercizio non è verificare se Lasso riesce a ridurre il numero dei coefficienti.
Il vero problema aziendale è capire se la selezione prodotta dal modello può diventare una base ragionevole per un processo operativo.
CloudDesk dispone di molte informazioni sui propri clienti. Ma il fatto che una variabile sia disponibile non significa che debba necessariamente essere utilizzata nel modello, né che debba essere monitorata con la stessa attenzione delle altre.
Lasso offre un meccanismo quantitativo per controllare la complessità.
Questo può aiutare a costruire modelli più compatti, più leggibili e potenzialmente più semplici da mantenere.
Ma la semplicità non deve essere confusa con la verità.
Se mrr riceve un coefficiente molto piccolo, non possiamo concludere che il valore economico del cliente sia irrilevante.
Possiamo soltanto osservare che, nel modello costruito, il contributo aggiuntivo di quella variabile è risultato limitato rispetto alle altre informazioni disponibili.
Lo stesso vale per una feature eliminata da Lasso.
Se due variabili sono fortemente correlate, il modello può mantenere una delle due e portare l’altra a zero. La feature eliminata non diventa per questo priva di informazione.
La stabilità della selezione diventa quindi un elemento importante.
Una variabile selezionata in quasi tutte le ripetizioni della procedura offre un’indicazione diversa da una variabile selezionata soltanto occasionalmente.
Anche la diagnostica dei residui ha un valore applicativo diretto.
Una struttura sistematica degli errori può indicare che manca una variabile importante, che una relazione è non lineare, che esistono segmenti differenti oppure che alcune osservazioni rappresentano casi particolari.
Il modello diventa quindi anche uno strumento per capire cosa non stiamo ancora rappresentando bene.
La peculiarità dell’esercizio sta proprio nel collegare tre livelli:
- statistico, perché Lasso controlla la complessità attraverso la penalizzazione L1;
- diagnostico, perché i residui mostrano dove il modello presenta strutture non spiegate;
- organizzativo, perché una previsione acquista valore quando può essere collegata a una decisione e a un’azione.
Una diagnostica completa non è un controllo finale
È facile trattare la diagnostica dei residui come una procedura da eseguire alla fine del progetto.
Costruiamo il modello, calcoliamo MAE e R², produciamo qualche grafico e archiviamo il risultato.
In realtà la diagnostica può avere un ruolo molto più interessante.
Supponiamo che i residui mostrino una chiara curvatura.
Potremmo rivedere la rappresentazione delle feature.
Supponiamo che compaiano cluster.
Potremmo verificare l’esistenza di segmenti con dinamiche differenti.
Supponiamo che pochi clienti abbiano residui estremamente elevati.
Potremmo controllare la qualità dei dati oppure scoprire un comportamento particolare del segmento enterprise.
Supponiamo infine che Lasso selezioni una feature in modo molto instabile.
Potremmo avere predittori fortemente correlati e dover riconsiderare la struttura del modello.
In tutti questi casi il problema non viene risolto dal grafico.
Il grafico ci indica dove guardare dopo.
La lezione dell’esercizio
Lasso è spesso presentato come un metodo per eliminare automaticamente le variabili meno importanti.
Questa descrizione è troppo semplice.
La penalizzazione L1 può produrre modelli più compatti, ma la selezione dipende da alpha, dalla struttura dei dati e dalle relazioni tra le feature.
Una variabile con coefficiente zero non è necessariamente inutile.
Una variabile con coefficiente diverso da zero non è necessariamente un driver causale.
Un modello con un R² elevato non è automaticamente un modello utile.
E un modello con un R² moderato non è automaticamente privo di valore.
Per CloudDesk la questione centrale è più concreta.
Il modello deve aiutare il team Customer Success a individuare segnali che possano essere verificati e trasformati in interventi.
Per questo la valutazione deve procedere su più livelli:
performance → selezione → stabilità → diagnostica → decisione.
Le metriche dicono quanto il modello sbaglia.
I coefficienti aiutano a capire quali informazioni vengono utilizzate.
La stabilità mostra quanto la selezione dipende dal campione.
I residui permettono di capire dove il modello non rappresenta adeguatamente il fenomeno.
La conoscenza del business permette infine di stabilire cosa fare con queste informazioni.
È questo il passaggio decisivo.
Un modello predittivo non diventa utile soltanto quando produce una buona previsione. Diventa utile quando le sue previsioni possono entrare in un processo in cui qualcuno sa quale segnale osservare, quale cliente verificare, quale azione intraprendere e come misurare il risultato.
La statistica costruisce il modello.
La diagnostica ne mette in evidenza i limiti.
Il processo aziendale decide come utilizzare ciò che il modello ha imparato.
Ed è proprio nell’intersezione tra questi tre livelli che una soluzione predittiva può diventare realmente utilizzabile.
📚 Per approfondire: correlazione, regressione e qualità dei modelli
Correlazione e regressione permettono di studiare le relazioni tra variabili, ma costruire un modello affidabile richiede anche di comprenderne i limiti. Questo percorso parte dalla correlazione tra variabili, introduce la regressione lineare e logistica e arriva alla multicollinearità, mostrando come interpretare correttamente risultati e coefficienti.