Un modello di Machine Learning può continuare a funzionare senza errori, produrre previsioni formalmente corrette e superare tutti i controlli della pipeline, mentre il contesto nel quale opera è diventato profondamente diverso da quello su cui è stato addestrato. È una situazione meno evidente di un errore di programmazione, ma potenzialmente più insidiosa, perché il sistema continua a restituire risultati anche quando le condizioni che ne sostenevano l’affidabilità potrebbero non essere più presenti.
Immaginiamo una piattaforma di e-commerce che utilizza un modello per stimare la probabilità che un cliente acquisti un prodotto. Durante l’addestramento, la maggior parte degli utenti ha visitato il sito da computer, ha acquistato prevalentemente prodotti di fascia media e ha risposto a campagne promozionali relativamente stabili. Dopo alcuni mesi, il traffico da dispositivi mobili aumenta, il catalogo viene riposizionato verso prodotti più costosi e le campagne pubblicitarie iniziano ad attirare segmenti di clientela differenti.
Il modello continua a ricevere le stesse variabili, ma la loro distribuzione cambia e le relazioni statistiche apprese durante l’addestramento potrebbero non rappresentare più adeguatamente il comportamento dei clienti. Se questa evoluzione non viene monitorata, le previsioni rischiano di diventare meno attendibili senza che si verifichi necessariamente un errore tecnico evidente.
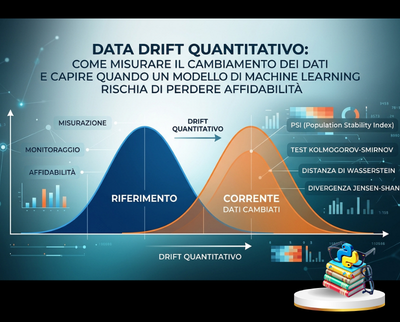
Questo fenomeno viene chiamato Data Drift e la sua analisi quantitativa consiste nel trasformare l’impressione che i dati siano cambiati in misure confrontabili, soglie operative e procedure di monitoraggio ripetibili.
L’obiettivo non è aggiornare automaticamente un modello ogni volta che compare una differenza statistica, bensì capire quanto i dati si siano allontanati dal riferimento, quali variabili siano coinvolte e se il cambiamento possa compromettere le decisioni aziendali. Per affrontare il problema occorre conoscere gli indicatori statistici più utilizzati, comprenderne i limiti e collegare i risultati a un processo di controllo delle prestazioni.
Che cos’è il Data Drift e quali fenomeni occorre distinguere
Il Data Drift si verifica quando la distribuzione delle variabili in ingresso a un modello cambia rispetto a una distribuzione di riferimento, che può essere costituita dai dati utilizzati durante la validazione oppure da un campione rappresentativo delle condizioni operative considerate accettabili.
Indicando con [math]X[/math] l’insieme delle feature, il cambiamento può essere rappresentato come:
[math]\displaystyle \begin{aligned} P_{\mathrm{ref}}(X)\neq P_{\mathrm{current}}(X) \end{aligned}[/math]
dove [math]P_{\mathrm{ref}}(X)[/math] descrive la distribuzione di riferimento e [math]P_{\mathrm{current}}(X)[/math] rappresenta quella osservata nel periodo corrente.
La distribuzione degli input, tuttavia, non esaurisce tutti i fenomeni che possono compromettere il funzionamento di un modello. È importante distinguere il Data Drift dal Prediction Drift e dal Concept Drift, perché ciascuno descrive un aspetto diverso dell’evoluzione del sistema.
Data Drift indica un cambiamento nella distribuzione delle feature in ingresso. Un aumento della quota di clienti che utilizzano dispositivi mobili, una variazione della distribuzione del valore degli ordini o una crescita delle visite mensili costituiscono esempi di questo fenomeno.
Prediction Drift indica un cambiamento nella distribuzione delle previsioni prodotte dal modello, per esempio quando un classificatore inizia ad assegnare più frequentemente la classe positiva oppure quando le probabilità di acquisto stimate diventano mediamente più basse. Questo segnale può essere utile per il monitoraggio, ma non dimostra da solo che la qualità delle previsioni sia peggiorata.
Concept Drift indica invece un cambiamento nella relazione tra gli input e il fenomeno da prevedere. In termini probabilistici, riguarda l’evoluzione di [math]P(Y\mid X)[/math], dove [math]Y[/math] rappresenta la variabile obiettivo. Un esempio è una promozione che in passato aumentava sensibilmente la probabilità di acquisto, ma che nel tempo perde efficacia perché i consumatori diventano meno sensibili agli sconti.
Le tre situazioni possono verificarsi contemporaneamente, ma non sono equivalenti. Una variazione di [math]P(X)[/math] non implica necessariamente un cambiamento di [math]P(Y\mid X)[/math], mentre una modifica della relazione tra input e risultato può manifestarsi anche quando le distribuzioni marginali delle singole feature rimangono sostanzialmente stabili.
Questa distinzione determina il modo in cui si costruisce un sistema di monitoraggio. Il Data Drift è spesso osservabile anche quando non sono ancora disponibili i risultati reali da prevedere, mentre la verifica diretta delle prestazioni richiede etichette corrette o esiti effettivi, che possono arrivare con settimane o mesi di ritardo.
Il problema quantitativo: rispetto a quale riferimento misuriamo il cambiamento?
Prima di scegliere un indicatore, occorre stabilire quali dati confrontare e quale significato attribuire alla distribuzione di riferimento.
Supponiamo di disporre di un dataset storico utilizzato durante la validazione del modello e di un dataset raccolto nell’ultima settimana. Il primo rappresenta il riferimento, mentre il secondo descrive il periodo corrente. Il confronto può essere effettuato per singola variabile, analizzando separatamente l’età del cliente, il valore del carrello, il numero di visite e il canale di acquisizione, oppure può riguardare la distribuzione congiunta delle feature, così da verificare se il profilo complessivo dei dati sia diventato riconoscibilmente diverso.
La scelta della finestra temporale è altrettanto importante, perché confrontare un giorno con un intero anno può produrre risultati difficili da interpretare a causa della diversa numerosità dei campioni, delle variazioni stagionali e della composizione della popolazione. È quindi preferibile confrontare finestre coerenti, per esempio settimane omogenee, verificando anche eventuali differenze tra giorni lavorativi e fine settimana.
Non sempre il dataset di addestramento costituisce il riferimento più appropriato. Se contiene dati molto vecchi, errori di raccolta o una composizione poco rappresentativa della normale operatività, il confronto potrebbe generare allarmi anche quando il sistema si trova in condizioni accettabili. Un riferimento più utile può essere un campione di validazione recente, rappresentativo delle condizioni nelle quali il modello ha dimostrato prestazioni adeguate.
Il riferimento deve essere documentato e versionato, registrando il periodo di raccolta, le regole di preparazione dei dati, le definizioni delle feature e le eventuali esclusioni effettuate. Cambiarlo continuamente per far scomparire gli allarmi significherebbe perdere proprio l’informazione che il monitoraggio dovrebbe conservare.
Occorre inoltre controllare che i due campioni siano stati costruiti con procedure compatibili, perché una modifica nel sistema di raccolta, nelle unità di misura o nelle regole di trasformazione può produrre differenze che dipendono dalla pipeline anziché da un cambiamento reale della popolazione.
Gli indicatori quantitativi per misurare il Data Drift
Non esiste un’unica metrica adatta a ogni problema, perché alcuni indicatori verificano la compatibilità statistica tra due campioni, altri quantificano una distanza tra distribuzioni e altri ancora sintetizzano le variazioni delle frequenze in un punteggio operativo. La scelta deve dipendere dalla natura della variabile, dalla numerosità dei dati, dal tipo di cambiamento che si vuole rilevare e dalle conseguenze che un eventuale errore potrebbe produrre.
Test di Kolmogorov-Smirnov
Per una variabile numerica continua, il test di Kolmogorov-Smirnov a due campioni confronta le funzioni di distribuzione cumulative empiriche dei dati di riferimento e di quelli correnti.
La statistica è definita come:
[math]\displaystyle \begin{aligned} D=\sup_x\left|F_{\mathrm{ref}}(x)-F_{\mathrm{current}}(x)\right| \end{aligned}[/math]
dove [math]F_{\mathrm{ref}}[/math] e [math]F_{\mathrm{current}}[/math] rappresentano le funzioni di distribuzione cumulative empiriche dei due campioni. Il valore [math]D[/math] misura la massima distanza verticale tra le due curve e può assumere valori compresi tra zero e uno.
Quando [math]D=0[/math], le due distribuzioni empiriche coincidono; valori più elevati indicano differenze più marcate, ma non esiste una soglia universale della statistica che determini da sola se il cambiamento sia operativamente rilevante.
Il test produce anche un p-value, che permette di valutare l’evidenza contro l’ipotesi nulla secondo cui i due campioni provengono dalla stessa distribuzione. Un p-value piccolo segnala una differenza statisticamente significativa nelle condizioni previste dal test, ma non quantifica direttamente l’importanza pratica del cambiamento.
Con campioni molto grandi, anche differenze contenute possono risultare statisticamente significative, motivo per cui il test dovrebbe essere affiancato a una misura dell’ampiezza della variazione e a una valutazione della sua rilevanza per il modello.
Il test standard presuppone inoltre campioni indipendenti e richiede particolare attenzione quando viene applicato a variabili discrete, come conteggi o indicatori binari, perché la distribuzione del test può non essere calibrata in modo appropriato rispetto alle ipotesi standard del caso continuo. Per variabili binarie è spesso più trasparente confrontare direttamente le proporzioni, eventualmente ricorrendo a test specifici per le proporzioni.
Population Stability Index (PSI)
Il Population Stability Index è frequentemente utilizzato nel monitoraggio dei modelli di scoring, del rischio e dei segmenti di clientela, perché sintetizza in un unico valore la variazione delle proporzioni osservate in diverse fasce di una variabile.
Per calcolarlo si suddivide la variabile in intervalli e si confronta la quota di osservazioni presente in ciascun intervallo nei due campioni:
[math]\displaystyle \begin{aligned} PSI=\sum_{i=1}^{k}(p_i-q_i)\ln\left(\frac{p_i}{q_i}\right) \end{aligned}[/math]
dove [math]p_i[/math] è la proporzione osservata nell’intervallo [math]i[/math] nel periodo di riferimento, [math]q_i[/math] è la proporzione nel periodo corrente e [math]k[/math] rappresenta il numero di intervalli.
Supponiamo che nella popolazione storica il 20% dei clienti appartenga a una determinata fascia di spesa e che nel periodo corrente la quota salga al 35%. Questa redistribuzione contribuisce ad aumentare il PSI, segnalando che la composizione della popolazione si è modificata.
Il risultato dipende dalla scelta degli intervalli, perché bin troppo ampi possono nascondere variazioni interne, mentre bin troppo numerosi possono produrre intervalli con poche osservazioni o frequenze nulle. Per le variabili continue si utilizzano spesso intervalli ricavati dai quantili del campione di riferimento, mantenendo gli stessi confini durante i confronti successivi.
Per le variabili categoriche e binarie, invece, il confronto deve essere effettuato sulle categorie esplicite, così da non perdere informazioni sulle variazioni delle frequenze. Una variabile che assume soltanto i valori zero e uno, per esempio, deve essere analizzata confrontando la proporzione di zeri e di uni nei due campioni, senza affidarsi a intervalli costruiti mediante quantili.
Nella pratica si incontrano spesso soglie orientative pari a 0,10 e 0,25, utilizzate rispettivamente per segnalare variazioni da approfondire e variazioni più marcate. Si tratta però di convenzioni operative, non di limiti statistici universali e nemmeno di garanzie sulla qualità del modello.
La formula richiede inoltre una gestione coerente delle frequenze nulle, perché il logaritmo di zero non è definito. È possibile applicare una procedura di smoothing, aggiungendo una piccola quantità alle frequenze prima di calcolare le proporzioni, purché il metodo venga dichiarato e applicato nello stesso modo a tutti i confronti.
Distanza di Wasserstein
La distanza di Wasserstein offre un’interpretazione intuitiva del cambiamento tra distribuzioni, perché misura il costo minimo necessario per trasformare una distribuzione nell’altra attraverso uno spostamento della massa probabilistica.
Nel caso unidimensionale, la distanza di Wasserstein di ordine uno è esprimibile come:
[math]\displaystyle \begin{aligned} W_1(P,Q)=\int_{-\infty}^{+\infty}\left|F_P(x)-F_Q(x)\right|\,dx \end{aligned}[/math]
dove [math]F_P[/math] e [math]F_Q[/math] sono le funzioni di distribuzione cumulative delle due distribuzioni confrontate.
A differenza di un test di significatività, questa misura restituisce una distanza e non un p-value. La sua scala dipende tuttavia dall’unità di misura della variabile, per cui una distanza di dieci euro non è direttamente confrontabile con una distanza di dieci anni.
Quando si vogliono confrontare feature differenti può essere necessario normalizzare le distanze, per esempio rapportandole a una scala di riferimento documentata, verificando che la normalizzazione non nasconda cambiamenti rilevanti. La distanza di Wasserstein è particolarmente utile quando interessa quantificare lo spostamento della distribuzione numerica, anziché limitarsi a stabilire se due campioni differiscano statisticamente.
Divergenza di Jensen-Shannon
Per distribuzioni discrete, la divergenza di Jensen-Shannon confronta due distribuzioni di probabilità attraverso una distribuzione intermedia definita come:
[math]\displaystyle \begin{aligned} M=\frac{P+Q}{2} \end{aligned}[/math]
La divergenza è quindi espressa come:
[math]\displaystyle \begin{aligned} JS(P,Q)=\frac{1}{2}KL(P\|M)+\frac{1}{2}KL(Q\|M) \end{aligned}[/math]
dove [math]KL[/math] indica la divergenza di Kullback-Leibler.
La Jensen-Shannon è simmetrica e, a differenza della divergenza KL ordinaria, è finita quando le distribuzioni confrontate hanno supporti diversi, purché la distribuzione intermedia e i termini nulli siano trattati correttamente. La sua scala dipende dalla base del logaritmo: con il logaritmo naturale la divergenza è compresa tra zero e [math]\ln 2[/math], mentre con il logaritmo in base due è compresa tra zero e uno.
È utile per confrontare variabili categoriche, come il canale di acquisizione, il tipo di dispositivo o la categoria merceologica, perché consente di quantificare la differenza tra le frequenze osservate nei due campioni.
Occorre distinguere la divergenza di Jensen-Shannon dalla distanza di Jensen-Shannon, definita come la radice quadrata della divergenza. Quando si confrontano risultati, soglie o implementazioni differenti è quindi necessario specificare quale delle due misure viene utilizzata e quale convenzione è stata adottata per il calcolo.
Quale metrica scegliere?
| Esigenza | Metodo indicativo | Aspetto da controllare |
|---|---|---|
| Confrontare distribuzioni numeriche continue | Kolmogorov-Smirnov | Significatività statistica, numerosità e ampiezza della differenza |
| Monitorare la stabilità di fasce di rischio | PSI | Scelta degli intervalli e gestione delle frequenze nulle |
| Quantificare lo spostamento di una distribuzione numerica | Wasserstein | Unità di misura e normalizzazione |
| Confrontare distribuzioni categoriche | Jensen-Shannon | Categorie rare, categorie nuove e base del logaritmo |
| Rilevare cambiamenti complessivi nelle feature | Classificatore di dominio | Capacità di distinguere il periodo di riferimento da quello corrente |
Questi metodi sono complementari e non devono essere considerati alternative perfettamente equivalenti. La scelta dipende dalla domanda aziendale, dal tipo di variabile e dal costo dei falsi allarmi; in un sistema di monitoraggio ben progettato, inoltre, la rilevazione del drift dovrebbe essere accompagnata da controlli sulla qualità dei dati e da verifiche periodiche delle prestazioni predittive.
Un laboratorio Python: misurare il Data Drift su dati di e-commerce
Per rendere il confronto concreto, costruiamo un esperimento che simula una variazione nel comportamento dei clienti di una piattaforma di e-commerce. Utilizzeremo pandas e NumPy per preparare i dati, SciPy per il test di Kolmogorov-Smirnov e Matplotlib per rappresentare graficamente le distribuzioni.
Lo scenario è intenzionalmente semplice: il campione di riferimento contiene clienti con un certo profilo di spesa e di utilizzo degli sconti, mentre il campione corrente rappresenta una popolazione nella quale il valore degli ordini è aumentato, il numero di visite è cambiato e la quota di clienti che utilizza gli sconti è diminuita.
I dati sono sintetici e vengono generati con un seme casuale fisso, così che l’esperimento sia riproducibile. I risultati servono a comprendere il comportamento degli indicatori in uno scenario controllato e non costituiscono evidenza empirica sul comportamento di un mercato reale.
Preparazione dell’ambiente e dei dati
In Google Colab o in un ambiente Python locale possiamo installare le librerie necessarie con il seguente comando:
%pip install numpy pandas scipy matplotlibCreiamo quindi due campioni indipendenti, ciascuno composto da 5.000 osservazioni. Il primo rappresenta la popolazione di riferimento, mentre il secondo introduce deliberatamente tre cambiamenti: un aumento della spesa media, un incremento delle visite mensili e una riduzione della probabilità di utilizzare uno sconto.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

from scipy.stats import ks_2samp

rng = np.random.default_rng(42)
n = 5000

# Popolazione di riferimento
reference = pd.DataFrame({
    "spesa_media": rng.normal(80, 20, n).clip(5, 250),
    "visite_mensili": rng.poisson(5, n),
    "sconto_utilizzato": rng.binomial(1, 0.30, n)
})

# Popolazione corrente
current = pd.DataFrame({
    "spesa_media": rng.normal(100, 25, n).clip(5, 300),
    "visite_mensili": rng.poisson(7, n),
    "sconto_utilizzato": rng.binomial(1, 0.22, n)
})

print("Riferimento:")
print(reference.describe().round(2))

print("\nPeriodo corrente:")
print(current.describe().round(2))
Riferimento:
spesa_media visite_mensili sconto_utilizzato
count 5000.00 5000.00 5000.00
mean 79.60 5.02 0.31
std 19.99 2.28 0.46
min 7.03 0.00 0.00
25% 66.16 3.00 0.00
50% 79.92 5.00 0.00
75% 92.62 6.00 1.00
max 149.08 15.00 1.00
Periodo corrente:
spesa_media visite_mensili sconto_utilizzato
count 5000.00 5000.00 5000.00
mean 99.47 7.05 0.22
std 24.90 2.67 0.41
min 5.19 0.00 0.00
25% 82.85 5.00 0.00
50% 99.30 7.00 0.00
75% 116.24 9.00 0.00
max 225.18 18.00 1.00
Le statistiche descrittive consentono di verificare che la simulazione abbia prodotto le variazioni previste. La spesa media passa da un valore atteso pari a 80 a un valore atteso pari a 100, il numero medio di visite mensili passa da 5 a 7 e la probabilità di utilizzo dello sconto diminuisce dal 30% al 22%.
Le medie osservate nei campioni non coincidono necessariamente con i valori attesi, perché dipendono dalla variabilità casuale, ma dovrebbero risultare sufficientemente vicine da rendere visibili i cambiamenti introdotti.
Calcolare il test KS e il PSI
Per il laboratorio distinguiamo le variabili continue da quelle discrete, perché la scelta della procedura di confronto deve rispettare la natura dei dati. Il test KS verrà applicato alla variabile continua spesa_media, mentre il PSI sarà calcolato sulla spesa attraverso intervalli determinati dai quantili del riferimento e sulle altre due variabili mediante le rispettive categorie osservate.
Questa distinzione evita che una variabile binaria venga suddivisa in intervalli poco informativi, situazione che potrebbe produrre un PSI nullo anche quando le proporzioni sono cambiate.
La funzione seguente calcola la statistica KS e il relativo p-value per due campioni numerici indipendenti:
def calcola_ks(reference, current):
    risultato = ks_2samp(
        reference,
        current,
        alternative="two-sided",
        method="auto"
    )

    return {
        "KS_statistica": risultato.statistic,
        "p_value": risultato.pvalue
    }
Per le variabili continue, la funzione del PSI ricava i confini degli intervalli esclusivamente dai quantili del campione di riferimento. I confini vengono poi mantenuti invariati anche per il campione corrente, così che le proporzioni siano confrontabili tra i due periodi.
def calcola_psi_numerico(reference, current, bins=10, alpha=0.5):
    reference = np.asarray(reference, dtype=float)
    current = np.asarray(current, dtype=float)

    if (
        not np.isfinite(reference).all()
        or not np.isfinite(current).all()
    ):
        raise ValueError(
            "Gestire i valori mancanti e non finiti prima del calcolo."
        )

    if len(reference) == 0 or len(current) == 0:
        return np.nan

    edges = np.unique(
        np.quantile(
            reference,
            np.linspace(0, 1, bins + 1)
        )
    )

    # Servono almeno due intervalli effettivi.
    # Un valore mancante è preferibile a uno zero fuorviante.
    if len(edges) < 3:
        return np.nan

    edges[0] = -np.inf
    edges[-1] = np.inf

    count_ref, _ = np.histogram(reference, bins=edges)
    count_cur, _ = np.histogram(current, bins=edges)

    p = (count_ref + alpha) / (
        count_ref.sum() + alpha * len(count_ref)
    )

    q = (count_cur + alpha) / (
        count_cur.sum() + alpha * len(count_cur)
    )

    return float(np.sum((p - q) * np.log(p / q)))
Il parametro alpha introduce uno smoothing simmetrico, necessario per evitare logaritmi non definiti quando un intervallo presenta una frequenza nulla in uno dei campioni. Il valore scelto è una convenzione dell’esempio e deve essere mantenuto coerente nei confronti successivi; quando la variabile contiene pochi valori distinti, inoltre, è preferibile utilizzare una rappresentazione categoriale anziché forzare la costruzione di intervalli numerici.
Per le variabili discrete e categoriche utilizziamo una funzione separata, che considera tutte le categorie osservate in entrambi i campioni e applica lo smoothing direttamente alle frequenze. La funzione tratta i valori mancanti come una categoria esplicita, così che anche una variazione nella quota di dati mancanti possa essere rilevata.
def calcola_psi_categorico(reference, current, alpha=0.5):
    ref = pd.Series(reference).astype(object).copy()
    cur = pd.Series(current).astype(object).copy()

    # I valori mancanti vengono monitorati come categoria.
    ref = ref.where(ref.notna(), "__MISSING__")
    cur = cur.where(cur.notna(), "__MISSING__")

    categorie = ref.unique().tolist()
    categorie += [
        x for x in cur.unique()
        if x not in categorie
    ]

    if not categorie:
        return np.nan

    count_ref = (
        ref.value_counts()
        .reindex(categorie, fill_value=0)
        .to_numpy(dtype=float)
    )

    count_cur = (
        cur.value_counts()
        .reindex(categorie, fill_value=0)
        .to_numpy(dtype=float)
    )

    p = (count_ref + alpha) / (
        count_ref.sum() + alpha * len(categorie)
    )

    q = (count_cur + alpha) / (
        count_cur.sum() + alpha * len(categorie)
    )

    return float(np.sum((p - q) * np.log(p / q)))
L’utilizzo di due funzioni separate rende esplicita una distinzione metodologica importante: per la spesa media interessa confrontare la distribuzione lungo una scala numerica, mentre per le visite mensili e per l’utilizzo dello sconto interessa confrontare le frequenze dei valori distinti. In un’applicazione reale, la scelta tra queste due modalità deve essere documentata insieme alle regole di gestione dei valori mancanti e delle categorie nuove.
A questo punto possiamo calcolare gli indicatori e raccogliere i risultati in una tabella. Per il test KS consideriamo soltanto la variabile continua per la quale l’interpretazione del test standard è più immediata.
risultati = []

for colonna in reference.columns:
    if colonna == "spesa_media":
        psi = calcola_psi_numerico(
            reference[colonna],
            current[colonna]
        )

        ks = calcola_ks(
            reference[colonna],
            current[colonna]
        )

        ks_statistica = ks["KS_statistica"]
        p_value = ks["p_value"]

    else:
        psi = calcola_psi_categorico(
            reference[colonna],
            current[colonna]
        )

        ks_statistica = np.nan
        p_value = np.nan

    risultati.append({
        "variabile": colonna,
        "KS": ks_statistica,
        "p_value": p_value,
        "PSI": psi
    })

report = pd.DataFrame(risultati)

print(report.round(5).to_string(index=False))
variabile KS p_value PSI
spesa_media 0.3616 0.0 0.73985
visite_mensili NaN NaN 0.66998
sconto_utilizzato NaN NaN 0.04370
La tabella consente di confrontare due prospettive: il test KS valuta l’evidenza di una differenza tra le distribuzioni della spesa media, mentre il PSI sintetizza le variazioni delle proporzioni nei rispettivi intervalli o nelle categorie. Il fatto che il test KS non venga calcolato per le variabili discrete non significa che queste non possano essere monitorate, ma che è opportuno utilizzare procedure coerenti con la loro natura.
Nella simulazione ci aspettiamo che la spesa media mostri un cambiamento evidente, mentre le frequenze delle visite mensili e dell’utilizzo degli sconti dovrebbero riflettere le modifiche introdotte nella generazione dei dati. I valori esatti dipendono dal campionamento casuale, dalla costruzione degli intervalli e dalla regola di smoothing adottata, per cui devono essere interpretati insieme alle statistiche descrittive e alle distribuzioni osservate.
È importante non confondere un valore del PSI pari a zero con un calcolo non riuscito: nel primo caso le proporzioni confrontate coincidono, mentre nel secondo l’indicatore non è disponibile e deve essere segnalato come tale. La distinzione evita di trasformare un problema tecnico in un falso segnale di stabilità.
Visualizzare il cambiamento delle distribuzioni
Un indicatore numerico permette di sintetizzare il cambiamento, ma una visualizzazione aiuta a capire se la differenza dipenda da uno spostamento della posizione, da una variazione della dispersione oppure da una redistribuzione tra categorie.
Per la spesa media utilizziamo un istogramma con le distribuzioni sovrapposte, mentre per le visite mensili e per l’utilizzo degli sconti confrontiamo direttamente le proporzioni osservate.
fig, axes = plt.subplots(1, 3, figsize=(15, 4))

# Distribuzione della spesa media
axes[0].hist(
    reference["spesa_media"],
    bins=30,
    density=True,
    alpha=0.5,
    label="Riferimento"
)

axes[0].hist(
    current["spesa_media"],
    bins=30,
    density=True,
    alpha=0.5,
    label="Corrente"
)

axes[0].set_title("Spesa media")
axes[0].set_ylabel("Densità")
axes[0].legend()

# Distribuzione delle visite mensili
for dati, etichetta in [
    (reference, "Riferimento"),
    (current, "Corrente")
]:
    frequenze = dati["visite_mensili"].value_counts(
        normalize=True
    ).sort_index()

    axes[1].plot(
        frequenze.index,
        frequenze.values,
        marker="o",
        label=etichetta
    )

axes[1].set_title("Visite mensili")
axes[1].set_xlabel("Numero di visite")
axes[1].set_ylabel("Proporzione")
axes[1].legend()

# Distribuzione dell'utilizzo degli sconti
categorie = [0, 1]
larghezza = 0.35
posizioni = np.arange(len(categorie))

p_ref = (
    reference["sconto_utilizzato"]
    .value_counts(normalize=True)
    .reindex(categorie, fill_value=0)
)

p_cur = (
    current["sconto_utilizzato"]
    .value_counts(normalize=True)
    .reindex(categorie, fill_value=0)
)

axes[2].bar(
    posizioni - larghezza / 2,
    p_ref.values,
    larghezza,
    label="Riferimento"
)

axes[2].bar(
    posizioni + larghezza / 2,
    p_cur.values,
    larghezza,
    label="Corrente"
)

axes[2].set_xticks(posizioni)
axes[2].set_xticklabels(["No", "Sì"])
axes[2].set_title("Sconto utilizzato")
axes[2].set_xlabel("Utilizzo dello sconto")
axes[2].set_ylabel("Proporzione")
axes[2].legend()

plt.tight_layout()
plt.show()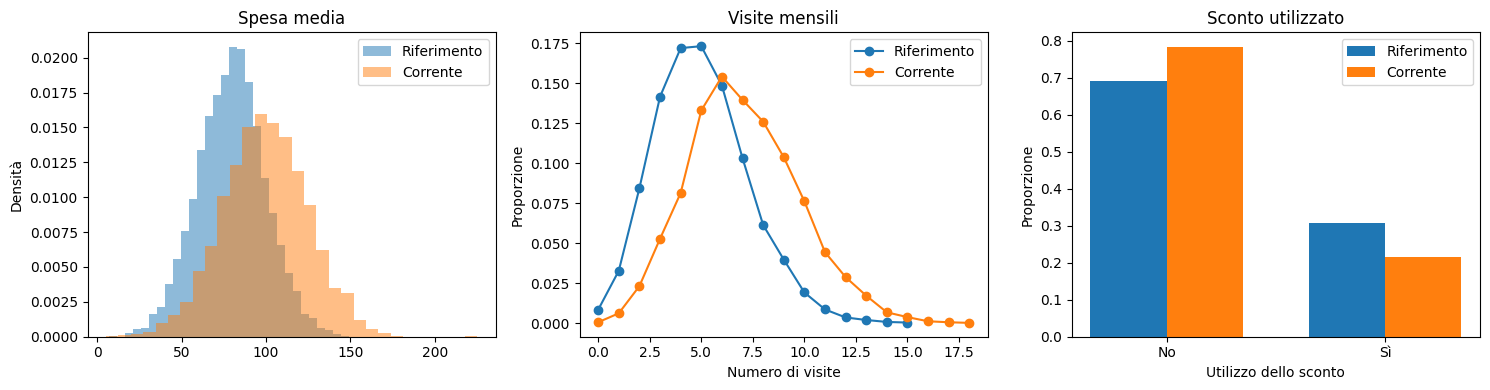
Le distribuzioni sovrapposte dovrebbero evidenziare lo spostamento della spesa verso valori più elevati, mentre i grafici delle variabili discrete permettono di verificare direttamente la redistribuzione delle frequenze. Nel caso degli sconti, per esempio, ci aspettiamo una riduzione della quota di clienti che li utilizzano, in coerenza con le probabilità impostate nella simulazione.
La visualizzazione non sostituisce la misurazione, ma aiuta a interpretarla e a verificare se il risultato numerico sia coerente con il comportamento dei dati. Se un indicatore segnala un cambiamento particolarmente marcato, osservare la forma delle distribuzioni può suggerire quali controlli aggiuntivi siano necessari.
Dalla metrica a un sistema di allerta
Un sistema di monitoraggio non dovrebbe limitarsi a stampare valori, perché una misura statistica diventa utile soltanto quando viene collegata a una regola di interpretazione e a un processo decisionale. Possiamo cominciare con una classificazione descrittiva basata sul PSI, utilizzando le soglie orientative che vengono spesso adottate nelle applicazioni di monitoraggio.
def classifica_psi(psi):
    if pd.isna(psi):
        return "Non disponibile"
    elif psi < 0.10:
        return "Variazione contenuta"
    elif psi < 0.25:
        return "Da approfondire"
    else:
        return "Variazione marcata"


report["segnale_PSI"] = report["PSI"].apply(
    classifica_psi
)

print(
    report[
        ["variabile", "PSI", "segnale_PSI"]
    ].round(4).to_string(index=False)
)
variabile PSI segnale_PSI
spesa_media 0.7399 Variazione marcata
visite_mensili 0.6700 Variazione marcata
sconto_utilizzato 0.0437 Variazione contenuta
Le soglie utilizzate sono convenzioni operative illustrative e non leggi statistiche. Un sistema antifrode, un motore di raccomandazione e un modello che supporta decisioni creditizie possono richiedere criteri diversi, perché le conseguenze di una variazione dei dati dipendono dal contesto nel quale le previsioni vengono utilizzate.
In produzione, una regola più robusta combina almeno tre elementi: l’entità del cambiamento osservato, la rilevanza della feature per le previsioni e la persistenza temporale del fenomeno. Una variazione moderata in una variabile determinante può essere più importante di una variazione elevata in una variabile marginale, mentre un’anomalia che compare in una sola finestra temporale potrebbe richiedere un controllo diverso rispetto a un cambiamento persistente.
Quando vengono effettuati molti test contemporaneamente, inoltre, aumenta la probabilità di ottenere falsi positivi. Per analisi estese può essere opportuno correggere i p-value, per esempio mediante la procedura di Benjamini-Hochberg per il controllo del false discovery rate, e affiancare i test a misure dell’ampiezza del cambiamento. La correzione statistica, tuttavia, non sostituisce la valutazione operativa: la rilevanza di una variazione deve essere giudicata anche in relazione alle decisioni che il modello supporta.
Data Drift e prestazioni: il controllo che non si può saltare
Il monitoraggio delle feature è un sistema di allerta, non una misura diretta della qualità predittiva. Per comprendere se il cambiamento dei dati abbia effettivamente compromesso il modello occorre verificare, quando gli esiti reali diventano disponibili, se le sue prestazioni siano peggiorate rispetto a un riferimento appropriato.
Per un problema di classificazione possiamo monitorare precision, recall, F1-score, ROC-AUC e calibrazione delle probabilità, scegliendo gli indicatori in base al tipo di errore che ha maggiore rilevanza. Per una regressione possiamo utilizzare MAE, RMSE o altre misure coerenti con il costo degli errori nel contesto applicativo.
Supponiamo che il sistema segnali una variazione nella spesa media dei clienti. Se il modello continua a mostrare prestazioni adeguate sui nuovi dati, il cambiamento potrebbe essere compatibile con la sua operatività e non richiedere un riaddestramento immediato. Se invece aumenta anche l’errore di previsione, diventa necessario indagare le cause, verificare la qualità delle feature e valutare se sia opportuno ricalibrare o aggiornare il modello.
È utile distinguere tre livelli di controllo:
| Livello | Domanda | Possibile azione |
|---|---|---|
| Dati | La distribuzione degli input è cambiata? | Analisi delle feature e della pipeline |
| Previsioni | È cambiata la distribuzione degli output del modello? | Analisi delle classi e delle probabilità previste |
| Prestazioni | Gli errori sono aumentati sugli esiti reali? | Diagnosi, ricalibrazione o riaddestramento |
Non è necessario aspettare sempre la disponibilità delle etichette per intervenire, perché un cambiamento anomalo nella qualità dei dati, una categoria sconosciuta o una rottura della pipeline possono richiedere un intervento immediato. Il solo Data Drift, tuttavia, non dovrebbe determinare automaticamente il riaddestramento: la decisione deve essere sostenuta da evidenze sufficienti e da una valutazione del rischio associato al modello.
Quando le etichette arrivano in ritardo, il monitoraggio può essere organizzato su due livelli complementari, utilizzando indicatori di drift e controlli sulla qualità degli input per individuare tempestivamente le anomalie e verificando successivamente le prestazioni non appena diventano disponibili gli esiti reali.
Come organizzare il monitoraggio in produzione
Una procedura concreta può essere articolata in passaggi che mantengano separati la rilevazione del cambiamento, la sua interpretazione e la decisione di intervenire.
Definizione del riferimento. Si conserva un campione rappresentativo delle condizioni nelle quali il modello è stato validato, registrandone versione, periodo di raccolta, caratteristiche e regole di preparazione.
Raccolta dei dati correnti. Gli input vengono aggregati in finestre temporali coerenti, controllando duplicati, valori mancanti, variazioni dello schema e anomalie nei processi di raccolta, perché un problema nella pipeline può essere scambiato per un cambiamento della popolazione.
Calcolo degli indicatori. Per ogni feature vengono applicate metriche appropriate al tipo di dato, con soglie documentate e verifiche sulla numerosità del campione. È importante conservare lo storico degli indicatori, in modo da distinguere una variazione occasionale da un fenomeno persistente.
Valutazione del rischio. I segnali vengono combinati con l’importanza delle variabili, la persistenza delle variazioni e, quando disponibili, gli indicatori di performance, così da attribuire priorità agli allarmi che possono avere conseguenze più rilevanti.
Intervento e verifica. Si correggono eventuali problemi della pipeline, si approfondiscono i cambiamenti di popolazione e si valuta il riaddestramento soltanto quando esistono motivazioni sufficienti, verificando successivamente che l’intervento abbia prodotto un miglioramento misurabile.
Questo processo può essere automatizzato attraverso una pipeline schedulata e integrato con dashboard, log e notifiche. Librerie come Evidently consentono di confrontare dataset di riferimento e correnti, generare report e configurare controlli di monitoraggio, ma la scelta delle metriche, delle soglie e delle regole di intervento deve comunque riflettere le caratteristiche del caso applicativo.
Per approfondire gli aspetti operativi è possibile consultare la documentazione ufficiale di Evidently dedicata al Data Drift.
Il monitoraggio dovrebbe inoltre essere accompagnato da una documentazione che registri gli allarmi, le verifiche effettuate e le decisioni prese, perché la tracciabilità permette di comprendere nel tempo se le soglie adottate siano adeguate e se gli interventi abbiano effettivamente ridotto il rischio.
Misurare il cambiamento prima che diventi un problema
Il Data Drift quantitativo permette di osservare come evolve la popolazione sulla quale opera un modello di Machine Learning, trasformando differenze potenzialmente difficili da riconoscere in indicatori confrontabili e in procedure di controllo ripetibili. Il test di Kolmogorov-Smirnov, il Population Stability Index, la distanza di Wasserstein e la divergenza di Jensen-Shannon forniscono prospettive differenti sullo stesso fenomeno, ma nessuna metrica, presa isolatamente, dimostra che un modello sia diventato inaffidabile.
La parte più importante del lavoro consiste nel collegare i numeri alle decisioni, distinguendo la significatività statistica dall’importanza pratica del cambiamento e verificando che i risultati siano coerenti con la natura delle variabili e con le modalità di raccolta dei dati. Un cambiamento può risultare statisticamente significativo ma essere irrilevante per il business, mentre una variazione concentrata in una feature critica può richiedere un approfondimento anche prima che sia possibile misurare un peggioramento delle prestazioni.
Un sistema maturo di monitoraggio non si limita quindi a chiedere se i dati siano cambiati, ma cerca di capire quali variabili siano coinvolte, con quale intensità si siano modificate le distribuzioni, per quanto tempo il fenomeno persista e quali conseguenze possa avere sulle previsioni. Quando gli esiti reali diventano disponibili, la verifica delle prestazioni completa l’analisi e permette di valutare se sia necessario intervenire sul modello.
È questo passaggio dalla semplice rilevazione statistica alla gestione del rischio predittivo che trasforma il Data Drift da indicatore tecnico a componente concreta della governance dei modelli di Machine Learning.
📚 Per approfondire: Data Drift, monitoraggio statistico e affidabilità dei modelli
Misurare il cambiamento delle distribuzioni è soltanto una parte del monitoraggio dei modelli di Machine Learning. Per interpretare correttamente gli indicatori, individuare le anomalie e verificare la qualità delle previsioni, ecco alcuni approfondimenti del blog dedicati ai test statistici, alle tecniche di rilevamento e alla valutazione delle prestazioni.
👉 Calibration Curve e Brier Score: come valutare la calibrazione delle probabilità di un modello
Approfondisce la valutazione delle probabilità previste e aiuta a distinguere un cambiamento degli input da un problema nella qualità delle previsioni.
👉 Carte di Controllo di Shewhart X̄-R: guida completa con teoria, Python ed esempi pratici
Spiega come distinguere le oscillazioni casuali dai cambiamenti persistenti nei processi, con applicazioni anche al monitoraggio dei sistemi di Machine Learning.
👉 Anomaly Detection in Produzione: pipeline con IQR, MAD e Isolation Forest
Approfondisce il rilevamento delle anomalie in contesti operativi, combinando metodi statistici robusti e algoritmi di Machine Learning.
👉 Isolation Forest Avanzato: guida a serie temporali e metriche custom in Python
Esamina il monitoraggio del drift, le serie temporali e la definizione di soglie operative coerenti con gli obiettivi aziendali.
Approfondisce la statistica D, il p-value e il confronto tra campioni, completando la parte metodologica dedicata al test KS.